Door categorieën bladeren
Nederlands
$
USD
Maak verbinding met je AI
Backend ontwikkelaar en specialist in lokale AI: Laravel, Python, RAG
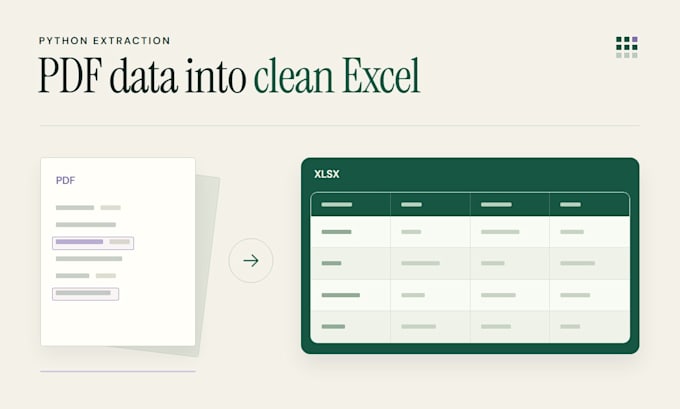
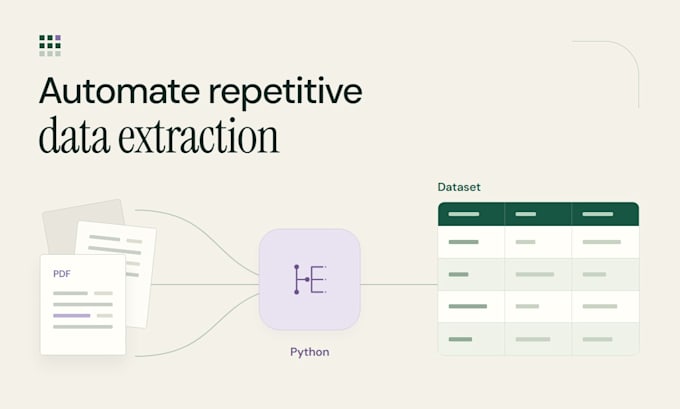
Zet herhalende PDF-rapporten om naar een schoon Excel- of CSV-bestand dat je daadwerkelijk kunt gebruiken.
Ik bouw Python-extractieworkflows voor leesbare, tekstopmaak-PDFs met een consistente lay-out. Jij bepaalt de kolommen; ik koppel de afgesproken velden, verwerk de batch en controleer de output-structuur.
Basic dekt tot 20 pagina’s en één lay-out. Standard voegt tot 70 pagina’s toe, twee lay-outs en een herbruikbaar Python-script. Premium dekt tot 150 pagina’s en drie lay-outs, met afgesproken validatiecontroles en run-documentatie. Veld-, bestands- en rijlimieten gelden.
Je ontvangt gestructureerde output, een korte extractiesamenvatting en een duidelijke lijst van zaken die gecontroleerd moeten worden. Standard en Premium bevatten ook het bronscript. Outputs worden vergeleken met het afgesproken schema; PDF-extractie kan nog menselijke controle vereisen.
Stuur me alsjeblieft een geanonimiseerde sample van elke lay-out en je doelkolommen voordat je bestelt. Scans, handgeschreven tekst, geavanceerde OCR, veranderende sjablonen en complexe bedrijfsregels vereisen een aparte beoordeling.
Technologie:
Excel
•
Google Sheets
•
Python
Automatische vertaling
Welke PDFs kun je verwerken?
Leesbare, op tekst gebaseerde PDFs met consistente veldlabels of tabelstructuren zijn het meest geschikt. Stuur een geanonimiseerde sample van elke lay-out voordat je bestelt, zodat ik de extractie kan beoordelen en het pakket kan bevestigen.
Is dit handmatige gegevensinvoer?
De dienst gebruikt Python om herhaalbare datastructuren te extraheren. Het is bedoeld voor terugkerende documentformaten, met een gedefinieerd schema en gecontroleerde uitvoer. Handmatige transcribering van variabele documenten valt buiten deze aanbieding
Wat telt als een andere lay-out?
Een lay-out gebruikt dezelfde veldlabels, veldposities en tabelstructuur. Anderen waarden of data zijn meestal prima. Een gewijzigde kopstructuur, verplaatste veld of nieuwe tabelindeling kan een andere extractielogica vereisen en telt als een andere lay-out.
Wordt het resultaat 100% nauwkeurig?
Er wordt geen nauwkeurigheidspercentage gegarandeerd. Ik controleer representatieve uitvoer, kijk naar de afgesproken structuur en markeer ontdekte uitzonderingen. PDFs kunnen ontbrekende tekst bevatten of een ongebruikelijke opmaak hebben, dus je moet gemarkeerde waarden beoordelen voordat je op de data vertrouwt
Kun je gescande PDFs of handschrift verwerken?
Scans, PDF's met alleen beelden, handschrift, geavanceerde OCR en documenten van lage kwaliteit vereisen een aparte beoordeling en een aangepaste offerte. Ze zijn niet inbegrepen in deze pakketten.