Door categorieën bladeren
Nederlands
$
USD
Koppel je AI aan Fiverr
Data Scientist en Machine Learning ontwikkelaar
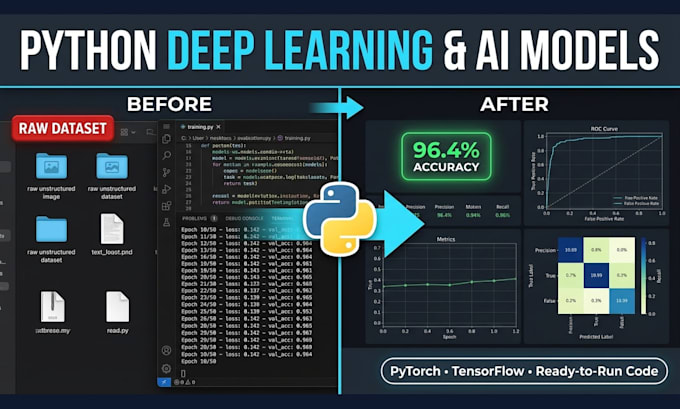
Nodig je een aangepast Deep Learning-model dat real-world nauwkeurigheid levert voor Computer Vision, Natural Language Processing (NLP) of Time-Series Forecasting?
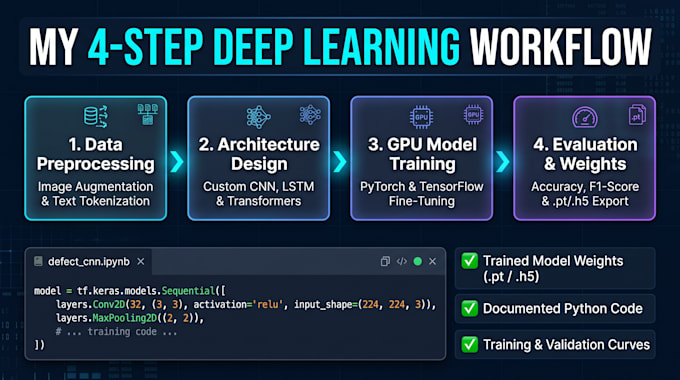
Als USAAI Hackathon-finalist en production AI-ontwikkelaar train, finetuneer en implementeer ik betrouwbare neurale netwerken met PyTorch, TensorFlow, Keras en HuggingFace, en lever zuivere inference-scripts en verifieerbare nauwkeurigheidsrapporten.
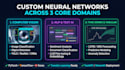
Belangrijkste Deep Learning-domeinen die ik behandel:
Computer Vision: beeldclassificatie, objectdetectie (YOLO, ResNet, OpenCV) en transfer learning op aangepaste beelddatasets.
NLP & Text AI: sentimentanalyse, aangepaste tekstclassificatie, entiteitsextractie en finetuning van transformers.
Tijdreeksen & sequentiële data: LSTM, GRU en diepe forecasting-modellen voor financiële-, sensor- of vraagdatasets.
Waarom beginnen met mijn Proof-of-Concept (PoC) van 90 dollar?
Diep leren vereist testen voordat je schaalt. Mijn Basic-pakket traint 1 baseline-architectuur op een stukje van jouw dataset (tot 2.000 rijen of 1.000 afbeeldingen) en levert een volledig verlies-/nauwkeurigheidsrapport op zodat je de haalbaarheid risicovrij kunt verifiëren.
Stuur me vandaag nog een bericht met de details van je dataset voor een GRATIS architectuur- en haalbaarheidscheck!


Programmeertaal:
Python
•
SQL
•
Colab
•
MLflow
API's:
Microsoft Computer Vision AI
•
Google Cloud Vision API
Tools:
Jupyter-notitieboek
•
opencv
•
tensorflow
•
Excel
•
MLflow
•
Colab
Frameworks:
Scikit-learn
•
keras
•
PyTorch
•
Panda
•
tensorflow
Automatische vertaling
Met welke deep learning-frameworks en -architecturen werk jij?
Ik bouw en stem modellen af met PyTorch, TensorFlow, Keras, HuggingFace Transformers en OpenCV—met CNNs (ResNet, EfficientNet, YOLO) voor beelden, Transformers/BERT voor NLP en LSTMs/GRUs voor tijdreeksen.
Mijn beeld- of tekstgegevensset is relatief klein. Kunnen we nog steeds hoge nauwkeurigheid halen?
Ja! In plaats van from scratch trainen op kleine datasets gebruik ik Transfer Learning (fijn-tunen van vooraf getrainde state-of-the-art gewichten) en data-augmentatie om hoge nauwkeurigheid te bereiken zonder overfitting.
Wat krijg ik precies bij oplevering?
Je ontvangt de getrainde modelgewichten (.pt, .pth of .h5), de gedocumenteerde Jupyter-notebook (.ipynb) en Python-inferentiescript (.py) om voorspellingen op nieuwe data uit te voeren, plus een visueel evaluatierapport (verliescurves, ROC-AUC, confusion matrix).
Kun je het getrainde neurale netwerk omzetten naar een web-app of REST API?
Zeker. In het Premium-pakket (of via een Custom Extra) zet ik je getrainde model achter een FastAPI REST-endpoint of een interactieve Streamlit-webdashboard zodat jouw team of gebruikers het live kunnen testen.