Door categorieën bladeren
Nederlands
$
USD
Koppel je AI aan Fiverr
Data Scientist en Machine Learning ontwikkelaar
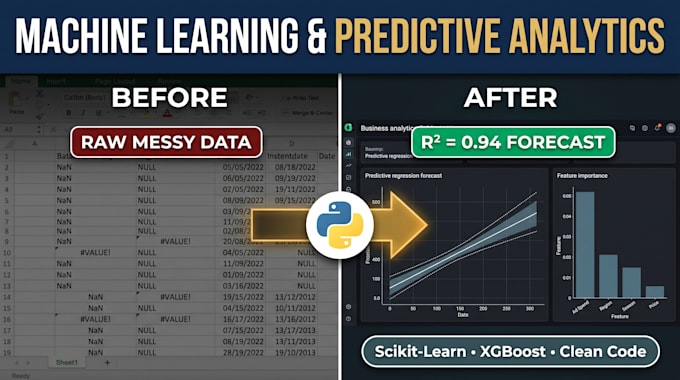
Zet je ruwe bedrijfsrekenbladen om in nauwkeurige prognoses, klantinzichten en automatische beslissingen.
Of je nu behoefte hebt aan verkoopprognoses, churn-voorspelling van klanten, krediet-/lead-scores of anomaliedetectie, ik bouw schone, production-ready Python Machine Learning-modellen die zijn afgestemd op jouw tabulaire data, niet op rommelig academisch notebooks die in de praktijk falen.
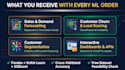
Wat je krijgt bij elke opdracht:
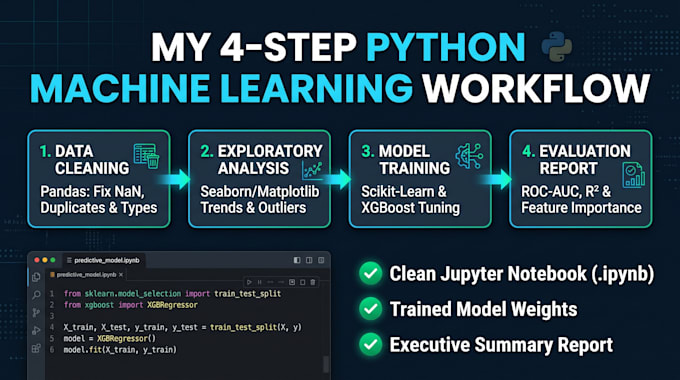
Gegevenshygiëne & EDA: omgaan met ontbrekende waarden, outliers, codering en schaalverdeling met Pandas & NumPy, plus overzichtelijke visuele verkennende grafieken.
Feature Engineering: precies bepalen welke variabelen jouw bedrijfsresultaten aansturen.
Modeltraining & -afstemming: Scikit-Learn, XGBoost, LightGBM, Random Forest of CatBoost met strikte cross-validatie om overfitting te voorkomen.
Evaluatierapport: duidelijke metrics (ROC-AUC, RMSE, confusion matrix, plots van Feature Importance) + gedocumenteerde Python-broncode.
Waarom starten met mijn $90 Proof-of-Concept (PoC)?
Voordat je honderden dollars uitgeeft aan een volledige softwarebouw, ruimt mijn Basic-pakket tot 5.000 rijen op en test ik 1 basismodel, zodat jij snel en verifieerbaar bewijs van nauwkeurigheid krijgt.
Stuur me vandaag nog je CSV/Excel-dataset of projectdoel en krijg een GRATIS haalbaarheidscheck!


Automatische vertaling
Mijn dataset bevat ontbrekende waarden, duplicaten en rommelige formatting. Kun je het eerst schonen?
Ja! Gegevensvoorbewerking en exploratieve data-analyse (EDA) met Pandas en NumPy zitten bij elk pakket inbegrepen. Ik verwerk ontbrekende waarden, uitschieters, codering van categorische variabelen en feature scaling voordat ik jouw model train.
Wat gebeurt er als mijn dataset niet genoeg signaal heeft voor 90%+ nauwkeurigheid?
Daarom is mijn $90 Basic-pakket ontworpen als een laagrisico Proof-of-Concept (PoC). Ik test een basismodel en laat upfront exact feature-importance en evaluatiemetrics zien voordat je investeert in een grotere pijplijn.
Welke Python-machine-learning-algoritmes en -bibliotheken gebruik je?
Ik gebruik Scikit-Learn, XGBoost, LightGBM, CatBoost, Statsmodels, Pandas en Optuna voor regressie, classificatie, clustering en tijdreeksvoorspelling, samen met Matplotlib/Seaborn voor visuele rapportage.
Kun je het getrainde model inzetten in een webdashboard of API?
Ja! In het Premium-pakket (of via een Custom Extra) verpak ik jouw getrainde machine learning-model in een interactieve Streamlit-webdashboard of een FastAPI REST-endpoint met volledige implementatie-instructies.
Kun je helpen met Deep Learning, NLP en AI projecten?
Absoluut. Ik werk aan Deep Learning, Natural Language Processing (NLP), Computer Vision, LLMs, AI chatbots, sentimentanalyse, tekstclassificatie en RAG toepassingen.
Levert u de broncode en documentatie?
Ja. Elk project bevat schone, goed gedocumenteerde en herbruikbare Python code, samen met uitleg en rapporten indien nodig.
Kun je werken met aangepaste datasets?
Ja. Ik kan werken met jouw dataset of helpen bij het verzamelen, schoonmaken, preprocessen en voorbereiden van data voor Machine Learning en Data Science projecten.
Moet ik contact met u opnemen voordat ik een bestelling plaats?
Ja. Neem contact met me op voordat je een bestelling plaatst, zodat we je wensen kunnen bespreken en de beste oplossing voor je project kunnen kiezen.
Kun je studenten, onderzoekers en bedrijven helpen?
Ja. Ik werk samen met studenten, onderzoekers, startups en bedrijven aan Data Science, Machine Learning, Python, AI en Data Engineering projecten.