Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD
Automatische vertaling
Stuur me eerst een bericht voordat je een bestelling plaatst - stuur een voorbeeld document en ik bevestig wat mogelijk is.
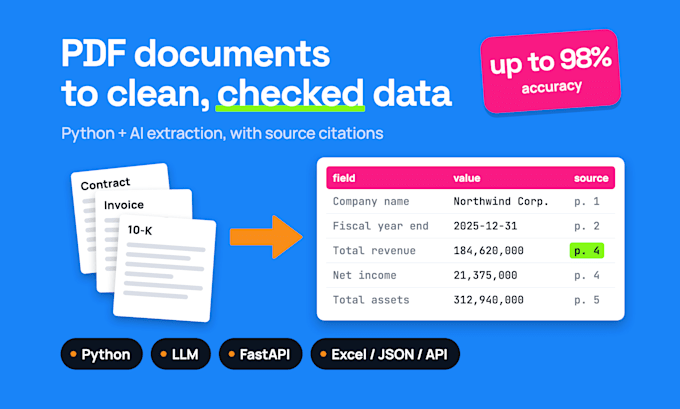
Ben je nog steeds handmatig cijfers aan het overtypen uit PDFs? Facturen, contracten, aanbestedingspakketten, financiële overzichten: één verkeerd gelezen cijfer kost meer dan de hele extractie.
Ik bouw Python pipelines die je documenten omzetten in schone tabellen - en laten zien waar elke waarde vandaan komt, zodat je het kunt controleren in plaats van blind te vertrouwen.
Wat je krijgt:
Waarom ik:
Geen match voor eenmalige copy-paste klusjes die je met ChatGPT kunt doen.
Stuur me een bericht met een voorbeeld document en wat je eruit wilt halen.
Python AI developer, over 12 years in IT, document AI and RAG in production
Talen
Automatische vertaling
Automatische vertaling
Waarom zou je voor mij kiezen?
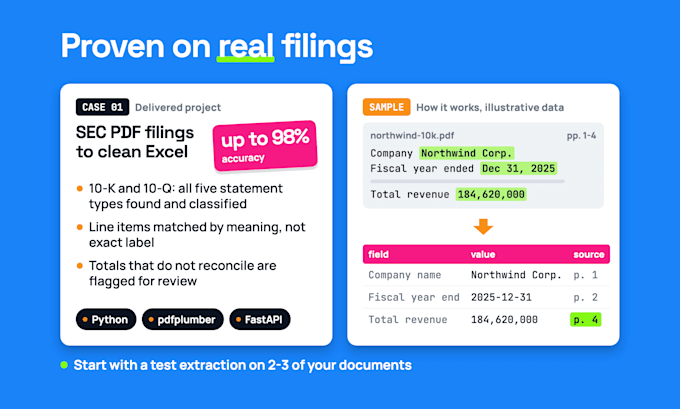
Ik bouw extracties die je kunt verifiëren: elke waarde blijft gekoppeld aan de bronpagina, en waarden waar het systeem niet zeker van is, worden gemarkeerd, niet geraden. Bewijs: SEC 10-K/10-Q verklaringen worden met tot 98% nauwkeurigheid geëxtraheerd naar Excel, 12+ jaar ervaring in IT.
Wat is erbij inbegrepen?
De deliverables van het pakket, de broncode (inclusief Docker), een nauwkeurigheidsrapport op je eigen voorbeeldbestanden, en een korte schriftelijke overdracht.
Wat is niet inbegrepen?
Handmatige gegevensinvoer, hostingkosten, LLM API-kosten, en documenttypes die niet in de order zijn afgesproken. Extra documenttypes kunnen later als extra worden toegevoegd.
Zijn mijn gegevens veilig?
Ja. Ik onderteken graag je NDA voordat je documenten deelt. Ik gebruik je bestanden alleen voor deze opdracht en verwijder ze na levering.
Kun je op mijn eigen documenten testen voordat ik de volledige build bestel?
Ja, dat is waarvoor het Basic pakket bedoeld is: ik voer de extractie uit op 2-3 van je eigen documenten en stuur een nauwkeurigheidsrapport en een plan. Je beslist over de volledige build pas nadat je echte cijfers hebt gezien.
Hoe nauwkeurig wordt het, en hoe meet je dat?
Dat hangt af van je documenten, dus ik meet het in plaats van het te beloven: elk geëxtraheerde veld wordt vergeleken met de juiste waarde op je voorbeelden, en je krijgt de nauwkeurigheid per veld in het rapport.
Verwerk je gescande PDFs (OCR)?
Ja. Tekst-PDF's worden direct gelezen; gescande PDFs gaan door OCR. Scankwaliteit beïnvloedt de nauwkeurigheid, dus gescande PDFs worden eerst getest in het Basic pakket op je eigen bestanden, voordat je je verbindt aan de volledige build.
Kun je tabellen uit PDFs halen?
Ja. Tabellen vormen de kern van mijn SEC 10-K/10-Q werk (financiële overzichten). Elke tabel wordt als rijen en kolommen in Excel, CSV of JSON weergegeven, met de bronpagina gekoppeld aan elke waarde.
Welke outputformaten lever je?
Standaard in Excel, CSV of JSON. Met de Export To Sheet & DB extra gaat de data direct naar je Google Sheet of database.
Kan het op mijn eigen server draaien?
Ja. Het Premium pakket wordt in Docker geleverd, zodat de pipeline op je eigen server draait en je documenten bij jou blijven.