Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD
Pakistan
1 bestelling voltooid
Datawetenschapper en full-stackontwikkelaar
Heb je data maar geen model? Training die dagen duurt op je laptop? Precisie die instort op echte data?
Dat los ik op.
Stuur me je dataset en doel, en ik train, evalueer en lever een model dat je kunt vertrouwen, met resultaten uitleggen in eenvoudige taal.
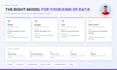
Hoe ik het aanpak
Wat verandert er voor jou
Ik vertel je vooraf welke nauwkeurigheid je data realistisch kan bereiken.
Stuur me een bericht met je dataset en doel voordat je bestelt. Ik controleer het en adviseer het juiste pakket.



Programmeertaal:
Python
•
R
•
MATLAB
•
SQL
•
Amazon SageMaker
Frameworks:
Scikit-learn
•
DeepPy
•
keras
•
PyTorch
•
Panda
•
tensorflow
Automatische vertaling
Welke gegevens heb je nodig om te beginnen?
Jouw dataset (CSV, Excel, beelden, tekst of database-export), jouw doel (wat je wilt voorspellen of classificeren), en eventuele notities over de data. Als je niet zeker bent over je doel, stuur me een bericht en we bepalen het samen.
Worden mijn gegevens vertrouwelijk behandeld?
Ja. Jouw data wordt alleen gebruikt voor jouw project, nooit gedeeld, en verwijderd na levering op verzoek. Ik teken graag een NDA als dat nodig is.
Is GPU-training inbegrepen in de prijs?
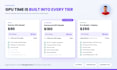
Ja. Basic omvat tot 10 GPU-uren, Standard tot 25, en Premium tot 50. Dat dekt de meeste projecten. Als jouw dataset of model meer nodig heeft, stuur ik een aangepaste offerte voordat we beginnen, zodat je niet voor verrassingen komt te staan.
Hoe groot kan mijn dataset zijn?
Basic behandelt tot ongeveer 50k rijen of 5k beelden, Standard tot 500k rijen of 50k beelden, Premium groter. Deep learning en fijn afstemmen hangen af van de modelgrootte, dus stuur me eerst een bericht en ik bevestig het juiste pakket.
Kun je een specifieke nauwkeurigheid garanderen?
Geen enkele eerlijke ML-engineer kan dat, omdat nauwkeurigheid afhangt van de kwaliteit en grootte van je data. Ik bekijk eerst je data en vertel je wat realistisch haalbaar is, en rapporteer getest resultaat op onzichtbare data.
Welke tools en frameworks gebruikt u?
Python met scikit-learn, XGBoost, PyTorch, TensorFlow en Hugging Face Transformers, plus Pandas en NumPy voor data voorbereiding. Als je project een specifieke library vereist, laat het me weten.
Kun je een pretrained model zoals BERT of een LLM fijn afstemmen?
Ja. Ik stem modellen zoals BERT en open-source LLMs fijn af op jouw data voor classificatie, sentimentanalyse, NER en soortgelijke taken. Dit wordt meestal gedekt door het Standard of Premium pakket.
Wat krijg ik uiteindelijk?
Het getrainde modelbestand, schone Python code of Jupyter notebook, en een evaluatierapport met metrics en grafieken. Standard en Premium voegen documentatie toe; Premium voegt cloud deployment en een API toe.
Kun je het model deployen zodat mijn app het kan gebruiken?
Ja. Het Premium pakket bevat cloud deployment met een API-endpoint dat je app of website kan aanroepen. Ik kan het ook inpakken met Docker als je het zelf wilt hosten.
Wat als de resultaten niet zijn wat ik verwacht?
Elk pakket bevat revisies voor tuning en aanpassingen. Als de data je doel niet kan ondersteunen, vertel ik dat vroegtijdig in plaats van een zwak model te leveren.


