Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD
Python Web Scraping Automatiseringsontwikkelaar
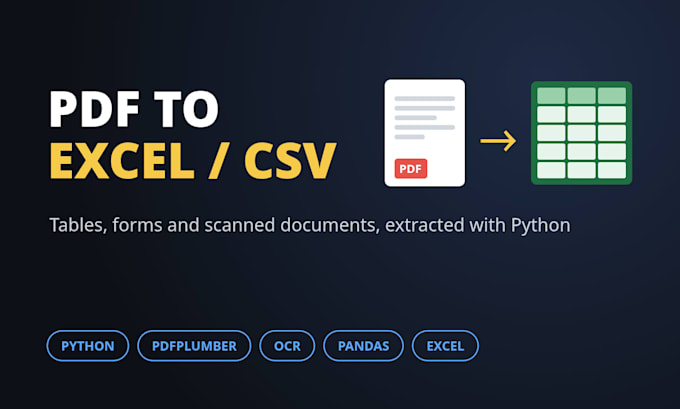
Heb je moeite met handmatig kopiëren van gegevens uit PDFs? Ik haal ze eruit met Python en zet ze in een schoon Excel- of CSV-bestand, klaar om te filteren en te analyseren.
Wat ik kan halen:
- Tabellen uit rapporten, facturen, bankafschriften en prijslijsten, zelfs als ze over meerdere pagina's lopen
- Invulformulieren: elk veld, selectievakje en dropdown, één rij per formulier
- Tekst uit gescande documenten met OCR (Tesseract), met handmatig gecontroleerde lage-waarde resultaten
- Alleen tekstoutput (.txt) in de juiste leesvolgorde, als dat is wat je nodig hebt
Hoe ik werk:
- Stuur me 1-2 voorbeeldbestanden voordat je bestelt, dan bevestig ik dat het mogelijk is
- Na je bestelling krijg je de eerste pagina's terug voor goedkeuring voordat ik de volledige batch verwerk
- Getallen en datums worden opgeslagen als echte getallen en datums, niet als tekst
- Ik controleer rij-aantallen en totalen met de bron, zodat er niets verloren gaat
Stack: Python, pdfplumber, PyMuPDF, pypdf, Tesseract OCR, Pandas, openpyxl.
In Standard en Premium krijg je ook het script, zodat de bestanden van volgende maand met één klik gaan.
Handgeschreven documenten kan ik niet betrouwbaar verwerken, stuur me eerst een bericht als jouw documenten handgeschreven zijn.
Technologie:
Python
•
Excel
•
Pandas
Type informatie:
Overige
Techniek:
Geautomatiseerd
Automatische vertaling
Kun je data uit gescande PDFs halen?
Ja, met OCR. De nauwkeurigheid hangt af van de scankwaliteit, stuur me eerst een voorbeeld en ik vertel je wat je kunt verwachten.
Mijn PDFs hebben verschillende indelingen. Is dat een probleem?
Nee. Elke indeling krijgt zijn eigen parsingregels. Het pakket geeft aan hoeveel indelingen inbegrepen zijn, extra indelingen kunnen worden toegevoegd.
Blijven mijn gegevens privé?
Ja. Je bestanden worden alleen gebruikt voor jouw opdracht en na levering verwijderd.
