Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD
Gegevensingenieur
Ik bouw betrouwbare en efficiënte gegevenspijplijnen met Python, SQL, PySpark en moderne ETL-workflows.
Of je nu CSV, Excel, JSON, API of databasegegevens hebt, ik help je bij het extraheren, schoonmaken, transformeren, valideren en voorbereiden voor analytics, rapportage of downstream toepassingen.
Mijn diensten omvatten:
Python data processing en automatisering
SQL queries en data transformatie
Ontwikkeling van ETL-pijplijnen
PySpark data processing
Data schoonmaken en valideren
API- en bestandgebaseerde data-extractie
Database-naar-database data-integratie
Data transformatie en workflow automatisering
Basis documentatie van pijplijnen
Ik richt me op het schrijven van schone, onderhoudbare en efficiënte code die is afgestemd op jouw wensen.
Heb je een kleine data taak, een ETL-workflow of een grotere data pipeline nodig, stuur me gerust een bericht met je wensen voordat je een bestelling plaatst. Ik bekijk je project en adviseer je over de meest geschikte aanpak.
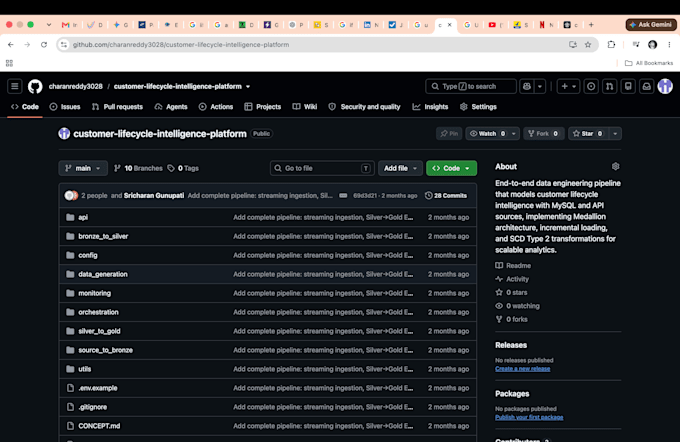
Warehouse Platform:
BigQuery
Projecttype:
Optimalisatie
