Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD
Nodig je data uitzoeken, opschonen en up-to-date houden automatisch? Ik bouw datapijplijnen die op zichzelf draaien, zodat je altijd verse, betrouwbare data hebt.
WAT IK BOUW
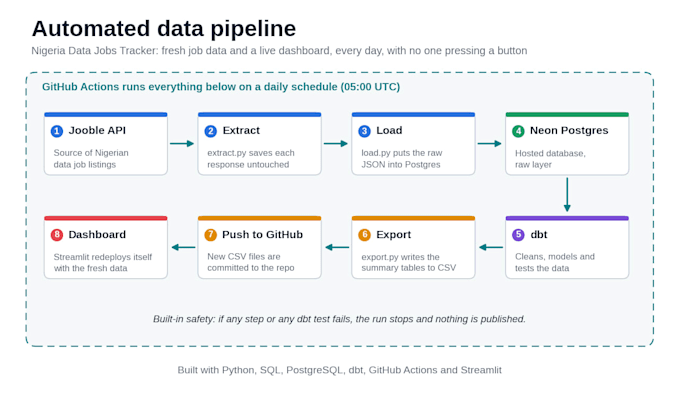
- Extractie uit API's en bestanden met Python
- Laden in PostgreSQL
- Opschonen en modelleren met dbt, met data quality tests
- Dagelijkse automatisering met GitHub Actions, geen server nodig
- Een live Streamlit-dashboard dat je opent met een link en ook naar elk einddoel naar jouw keuze
HET BEWIJS DAT HET WERKT
Ik heb de Nigeria Data Jobs Tracker gebouwd en gerund: het haalt dagelijks vacatures op, ruimt ze op met dbt en werkt automatisch een openbaar dashboard bij.
Live demo: nigeria-job-market-tracker-c2dqzraz9ouopa9qo4cgnt.streamlit.app
ZOWER IK WERK
- Jij vertelt me jouw databron en wat je wilt zien
- Ik bouw de pijplijn en lever de code op
- Tests draaien bij elke update, zodat slechte data wordt opgevangen voordat het jouw dashboard bereikt
Hulpmiddelen: Python, SQL, PostgreSQL, dbt, GitHub Actions, Streamlit, Docker.
Stuur me een bericht vóór je bestelt met een korte beschrijving van jouw data, dan raad ik het juiste pakket aan.
Automatische vertaling
Wat heb je van mij nodig om te beginnen?
De data bron (een API, bestanden of een database), wat je wilt meten en waar de data eindigt.
Kan de pipeline automatisch elke dag draaien?
Ja. Het Premium-pakket bevat een dagelijkse planning met GitHub Actions, zodat het zonder iemand die het moet starten draait.
Krijg ik de broncode?
Ja, alle pakketten bevatten de volledige source code.