Door categorieën bladeren
Nederlands
$
USD
Koppel je AI aan Fiverr
AI ontwikkelaar Machine Learning Engineer Python FullStack ontwikkelaar


Automatische vertaling
Kun je elke website schrapen?
Nee — en elke verkoper die ja zegt, raadt het slechts. Ik verzamel uit openbare bronnen die jij mag gebruiken, met respect voor snelheidslimieten en voorwaarden. Sites achter inlog, betaalmuren, CAPTCHAs of anti-bot-bescherming vallen buiten de service, en sites die automatische toegang blokkeren kunnen na inspectie worden geweigerd.
Welke dataformaten lever je aan?
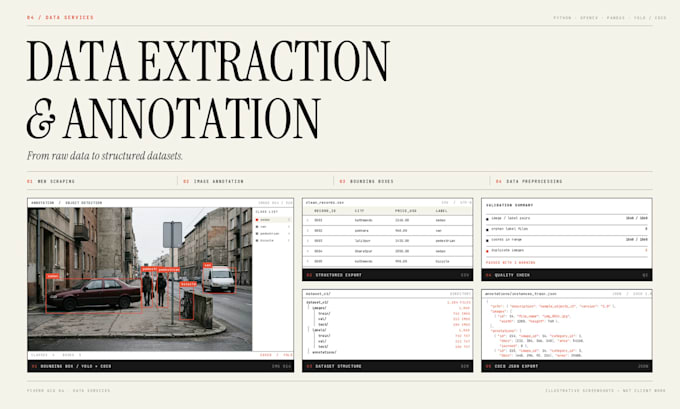
CSV, Excel (XLSX), JSON, YOLO .txt-bestanden met een data.yaml, COCO JSON, georganiseerde afbeeldingsmappen en documentatie in Markdown of PDF. Eén uitvoerformaat is inbegrepen in een pakket; een tweede formaat voor dezelfde data is apart geoffreerd.
Kun je afbeeldingen annoteren met bounding boxes?
Ja. Ik voeg objecten toe volgens een afspraak die voorafgaand aan het werk is gemaakt: hoe strak de doos langs het object loopt, of gedeeltelijk zichtbare objecten meetellen, hoeveel dozen per afbeelding, en hoe klassen worden genoemd. Dozen kunnen geleverd worden met jouw klassenlijst precies zoals geschreven.
Ondersteun je YOLO- en COCO-formaten?
Ja, beide — YOLO genormeerde .txt-bestanden met een data.yaml en COCO JSON met afbeeldingen, annotaties en categorieën. Ik kan ook tussen hen omzetten, of een CSV met pixelcoördinaten leveren als jouw pipeline dat nodig heeft.
Kun je een bestaande dataset schoonmaken en voorbewerken?
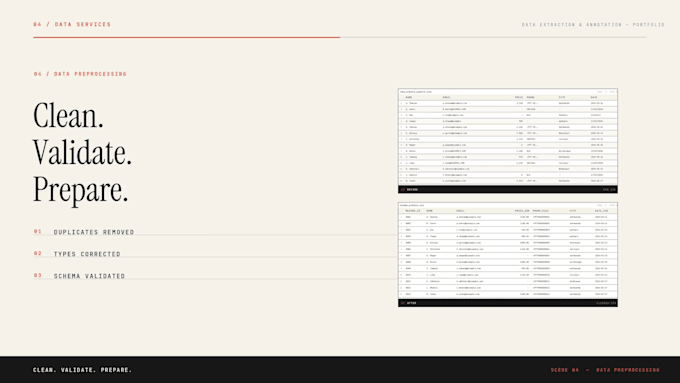
Ja. Dat omvat duplicaatverwijdering met een telling, ontbrekende waarden naar jouw keuze, type- en datumcorrecties, spatie- en hoofdletternormalisatie, kolomhernoeming, afbeeldingsresizing en validatie van de uitvoer. Originelen blijven bewaard en er wordt een korte transformatielog meegeleverd.
Kun je afbeeldingen en labels in mappen organiseren?
Ja. Ik zet structuren op zoals images/, labels/ en annotations/, splits in train/validation/test zoals afgesproken, controleer of elke afbeelding een bijpassend labelbestand heeft, rapporteer ontbrekende bestanden en stem aantallen af tussen de splits.
Train je machine learning modellen?
Niet bij deze dienst. Deze service eindigt bij de data: verzamelen, labels, schoonmaken, structuur en documentatie. Modeltraining, fijnafstelling en evaluatie zijn een aparte dienst — een voorbereide dataset vanuit hier kan dat werk aanleveren, maar je betaalt er niet voor in deze bestelling.
Kunt u overweg met grote datasets?
Binnen de hoeveelheden die bij elke pakket zijn aangegeven (tot 1.500 records of 250 geannoteerde afbeeldingen in Premium). Grotere volumes zijn mogelijk maar worden apart geoffreerd nadat ik een voorbeeld heb gezien, omdat annotatie-inzet afhangt van afbeeldingen × klassen × objecten per afbeelding, niet van bestandsgrootte alleen.
Hoe wordt de annotatiekwaliteit gecontroleerd?
Aan de hand van criteria die vóór de bestelling zijn afgesproken: het klassendefinitieblad, jouw schriftelijke instructies, een afgesproken reviewpercentage (bijv. 10% van de afbeeldingen opnieuw gecontroleerd), en de in de briefing vastgelegde conventies. Vaaggevallen worden gelogd in plaats van stilzwijgend beslist. Wat ik niet aanbied is een allesomvattende clausule.
Moet ik iets sturen voordat ik bestel?
Een korte briefing: wat de data is, waar die ligt, hoeveel er is, de klassenamen als annotatie betrokken is, en het formaat dat je nodig hebt. Screenshots van een bestaand annotatiebestand helpen enorm. Stuur het als bericht en je krijgt een omvattende scope-notitie met hoeveelheid, formaat, prijs en levertijd.