Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD
Machine Learning en Data Science
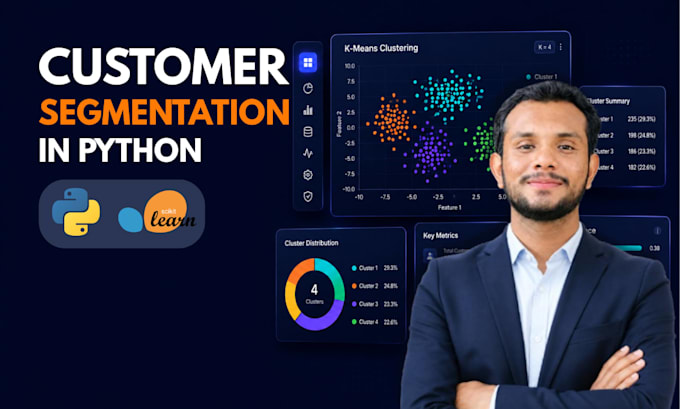
Behandel je al je klanten hetzelfde? Als dat zo is, laat je geld liggen. Verschillende klanten hebben verschillende koopgedragingen, en een one-size-fits-all marketingstrategie werkt gewoon niet.
Ik voer geavanceerde klantsegmentatie uit met behulp van ongesuperviseerde machine learning algoritmes in Python. Door je data te analyseren en klanten te groeperen op basis van hun aankoopgewoonten, bestedingspatronen en engagement metrics, help ik je om zeer winstgevende segmenten te ontdekken en gebruikers te identificeren die opnieuw betrokken moeten worden.
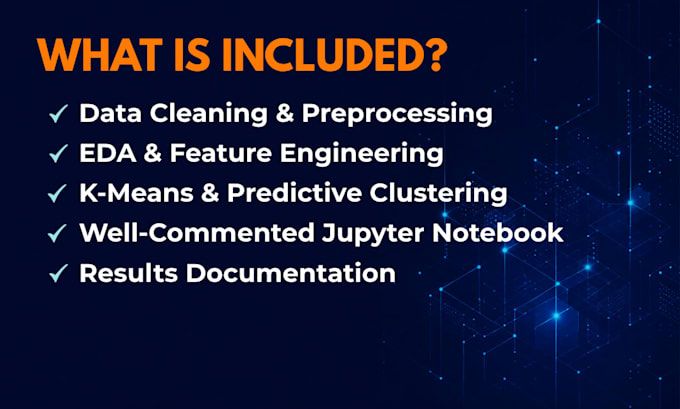
Wat je krijgt:
Technische stack: Python, Pandas, Scikit-learn, Matplotlib, Seaborn.
Stuur me een bericht met je dataset en doelen voordat je bestelt!
Expertise:
Representatieleren
•
clustering
•
Voorspellende analyse
Programmeertaal:
Python
•
SQL
Frameworks:
Scikit-learn
•
Panda
Tools:
Jupyter-notitieboek
•
Excel
•
Colab
Automatische vertaling
Welke data is nodig voor klantsegmentatie?
Ik heb je klantendataset nodig in CSV- of Excel-formaat. Idealiter bevat deze transactiegeschiedenis (zoals aankoopfrequentie en totale uitgaven), demografische gegevens of engagement metrics van je CRM of e-commerce winkel.
Wat krijg ik precies aan het einde van het project?
Afhankelijk van je gekozen pakket krijg je een volledig gedocumenteerd Python-script (Jupyter Notebook), een nieuwe CSV-bestand met je klanten toegewezen aan hun specifieke clusters, visuele grafieken (zoals scatter plots) en actiegerichte zakelijke inzichten.
Integreer je dit machine learning model in mijn website?
Nee, deze dienst richt zich puur op het bouwen en valideren van het kernmachine learning algoritme. Ik lever de .ipynb broncode en getrainde modelbestanden, die jouw backend team eenvoudig kan integreren in je live systemen.
Hoe bepaal je het juiste aantal klantgroepen (clusters)?
Ik gok niet zomaar! Ik gebruik geavanceerde wiskundige validatietechnieken zoals de Elbow Method en Silhouette Score in Scikit-learn om het meest optimale en onderscheidende aantal segmenten voor jouw data te vinden.
Is mijn bedrijfsdata veilig en vertrouwelijk?
Absoluut. Jouw klantgegevens worden strikt gebruikt voor de afgesproken machine learning analyse en worden nooit gedeeld, verkocht of hergebruikt. Ik sta volledig open voor het ondertekenen van een NDA (Non-Disclosure Agreement) voor jouw gemoedsrust.