Door categorieën bladeren
Nederlands
$
USD
Koppel je AI aan Fiverr
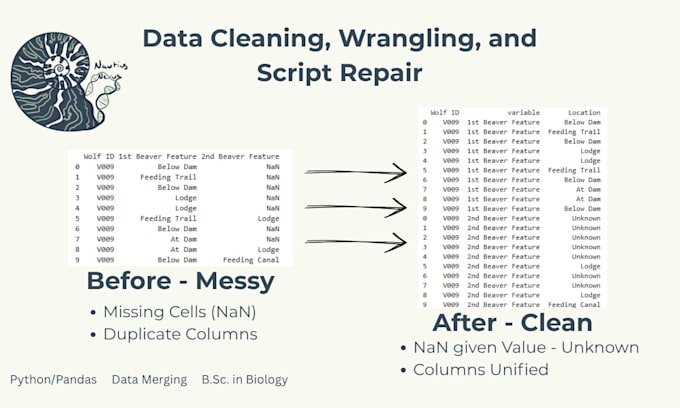
Ben jij een promovent, onderzoeker of academicus die worstelt met gebroken code of een rommelige dataset? Als data-analist met een B.S. in Biologie en een minor in Psychologische Wetenschap begrijp ik dat jouw data uren nauwkeurige waarnemingen en fysiek werk vertegenwoordigen, en niet zomaar bedrijfsspreadsheets zijn. Ik richt me op de mechanische uitvoering van data cleaning, zodat jij je volledig kunt richten op je scriptie, commissierichtlijnen of andere urgente zaken.
Wat ik doe:
Code Debugging: syntaxisfouten, lussen of lay-outwaarschuwingen uit je Jupyter-notebooks halen.
Data Wrangling: ruwe formaten herstructureren, ontbrekende cellen afhandelen en tekstcategorieën normaliseren.
Multi-Stream Integratie: tot 3 aparte logs of spreadsheets samenvoegen tot één, verenigde dataset.
Opmerking: om de integriteit van data te beschermen, worden je ruwe bestand en onderzoeks hypotheses bevroren zodra de opdracht start.
Voor enorme datasets die de basisrijthresholds overschrijden, kies bij het afrekenen de extra optie 'Extra Data of Bestand'. Voor een extra project-notebook kies hetzelfde. Wil je een uitleg van de code, kies dan 'Code Documentation'.
Bekijk mijn openbare code op github.com/skyegambrel
Automatische vertaling
Welke specifieke bestandsformaten accepteer je voor data cleaning?
Ik accepteer standaard tabulaire dataformaten zoals CSV, XLSX (Excel), TSV en TXT, evenals Jupyter Notebook-scriptbestanden (.ipynb) voor debugging. Zorg ervoor dat je bestandstructuren niet versleuteld zijn voordat je ze uploadt naar het requirements-paneel.
Wat telt als één "Item Cleaned" of datasetbestand?
Een enkel item verwijst naar één op zichzelf staande spreadsheet, datasheet of broncode-notebook. Tier 1 dekt één kapot scriptbestand, Tier 2 dekt één ruwe databestand (tot 200 rijen), en Tier 3 de reiniging en structurele integratie van maximaal 3 losse bestanden.
Hoe ga je om met ontbrekende waarden, lege cellen of NaN in mijn dataset?
• Ik gebruik gespecialiseerde Python-bibliotheken (Pandas en NumPy) om ontbrekende data-patronen te isoleren. Afhankelijk van jouw expliciete instructies schrijf ik schone pipelines om lege rijen te verwijderen, structurele hiaten te isoleren of ontbrekende categorieën te imputeren op basis van jouw projectvereisten—zonder valse data.
Zul je de Python-code of gebruikte bibliotheken uitleggen die je hebt gebruikt om mijn bestanden op te schonen?
De basistiers leveren het schone data-bestand en je geannoteerde script. Als je een uitgebreide, regel-voor-regel uitleg in platte Engels wilt van de exacte Pandas-functies die zijn gebruikt, zodat je het datapijplijn gemakkelijk kunt verdedigen bij je commissie, kies dan de extra optie "Code Documentation" bij het afrekenen.
Onderteken je geheimhoudings- of dataprivacy-clausules (NDAs)?
Volgens Fiverrs strikte, beveiligde platformvertrouwelijkheidsregels worden je ruwe brondata, observatienotities en hypotheses behandeld als strikt vertrouwelijke intellectuele eigendom en worden nooit gedeeld of gepubliceerd.
