Door categorieën bladeren
Nederlands
$
USD
Koppel je AI aan Fiverr

Automatische vertaling
Heb je een machine learning model nodig dat getraind is op jouw data, met eerlijke en duidelijke resultaten?
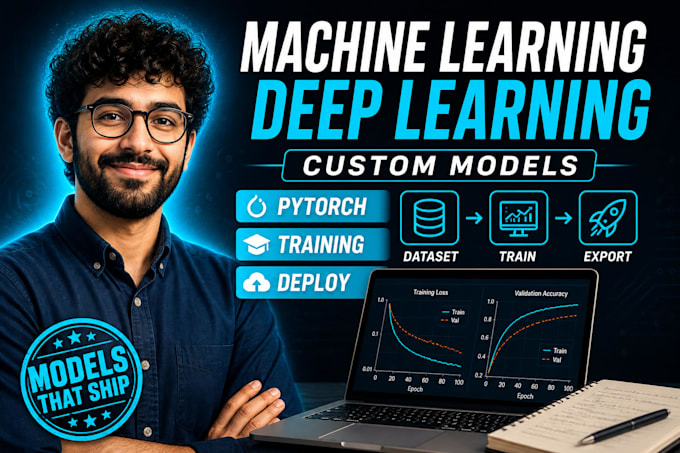
Ik train ML- en deep learning-modellen in Python met scikit-learn, XGBoost, PyTorch en TensorFlow, voor classificatie, regressie, tekst- en afbeeldingtaken.
Ben je hier nieuw? Begin met het Basic pakket: één model op jouw schone dataset met evaluatiemetrics en een Jupyter notebook, geleverd binnen 3 dagen. Het is een eenvoudig, laag-risico eerste project.
Wat je krijgt:
- Probleemdefinitie: wat te voorspellen en hoe het te meten
- Een baseline model, gevolgd door een sterker model waar het helpt
- Een juiste train- en test-split zodat de resultaten niet worden overschat
- Duidelijke metrics zoals nauwkeurigheid, F1, RMSE of een verwarringsmatrix
- Een schoon notebook met commentaar dat je kunt herhalen
- Een opgeslagen modelbestand en een predictiescript (Standard en Premium)
Standard voegt datacleaning, feature work en modelvergelijking toe. Premium voegt deep learning of een deploy-klaar predictiescript of kleine API toe.
Hoe het werkt:
1. Stuur je dataset en vertel wat je wilt voorspellen
2. Ik controleer de data en bevestig het plan voordat ik begin
3. Je krijgt het notebook, model en een korte samenvatting van de resultaten
Ik vertel je eerlijk of je data te klein of te ruisig is voor het resultaat dat je wilt.
AI Engineer, RAG, ML and Agents
Talen
Automatische vertaling
Automatische vertaling
Wat is een schone dataset voor het $30 Basic pakket?
Eén tabel (CSV of Excel) met een duidelijke target kolom, geen grote ontbrekende data en tot ongeveer 100k rijen. Als je data schoonmaak, samenvoegen of labelen nodig heeft, is Standard de betere keuze.
Kun je een specifieke nauwkeurigheid garanderen?
Nee. Resultaten hangen af van je data. Ik geef je eerlijke metrics op de testdata die niet gebruikt is voor training, leg uit wat de score beperkt en doe suggesties om het te verbeteren.
Welke tools en frameworks gebruikt u?
Python met Pandas, scikit-learn en XGBoost voor tabulaire data, en PyTorch of TensorFlow voor deep learning, tekst en afbeeldingen. Als je een specifieke library nodig hebt, laat het me weten voordat je bestelt.
Doe je aan computer vision of NLP?
Ja, bijvoorbeeld beeldclassificatie of tekstclassificatie en sentimentanalyse. Deze passen meestal bij Standard of Premium omdat ze meer data voorbereiding en trainingstijd vereisen.
Wat krijg ik uiteindelijk?
Een Jupyter notebook, het getrainde modelbestand, metrics en een korte samenvatting in eenvoudig Engels. Premium kan een predictiescript of een kleine API bevatten zodat je het model in je app kunt gebruiken.
