Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD
Senior Data Engineer
Ben je op zoek naar een ervaren Data Engineer om betrouwbare en schaalbare data pipelines te bouwen?
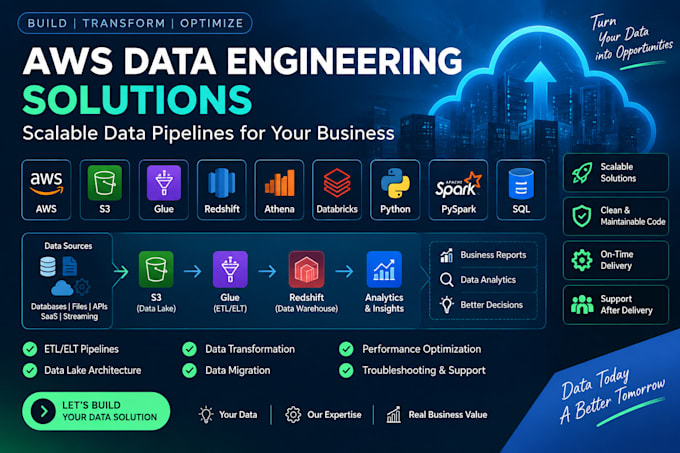
Ik ontwikkel en optimaliseer AWS data engineering, ETL/ELT, en data verwerkingsoplossingen met Python, PySpark, SQL, AWS Glue, S3, Redshift, Athena, en Databricks.
Wat ik voor je kan doen:
Ik richt me op het schrijven van schone, schaalbare, onderhoudbare en productieklare data oplossingen gebaseerd op jouw bedrijfsbehoeften.
Of je nu een nieuwe data pipeline nodig hebt, een bestaande workflow wilt optimaliseren, of hulp nodig hebt bij het troubleshoot van je data engineering project, ik kan je helpen.
Technologieën: AWS | Python | PySpark | SQL | Glue | S3 | Redshift | Athena | Databricks | Delta Lake
Expertise:
CI/CD
•
Monitoring en logging
•
Automatisering
Cloudprovider:
Amazon Web Services
