Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD
Automatische vertaling
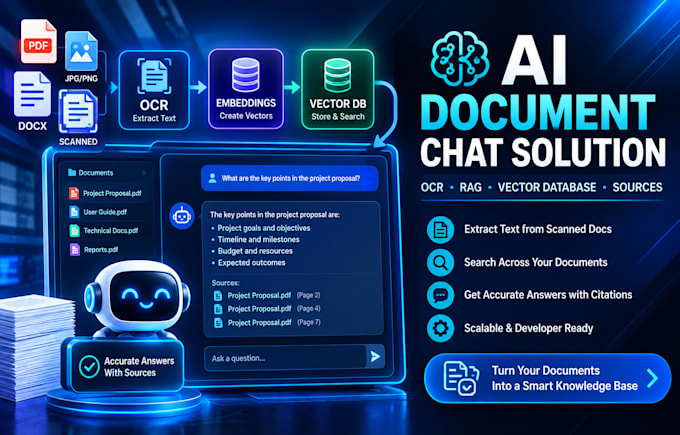
Heb je een betrouwbare backend-architectuur nodig voor een AI document chat systeem?
Wat ik kan bouwen
Ik kan rekening houden met issues zoals:
Stuur me je documenttypes, verwachte pagina volume en voorkeurs technologie stack, en ik help je de backend pipeline in kaart brengen.
Your AI System Built Right From Day One
Talen
Automatische vertaling
Automatische vertaling
Kun je een chatbot bouwen die vragen beantwoordt uit mijn PDF documenten?
Ja. Ik kan een document-chat systeem bouwen waarbij gebruikers PDFs uploaden en vragen stellen, met antwoorden die worden gegenereerd uit de inhoud van het document.
Wat als mijn PDFs gescand zijn en geen selecteerbare tekst bevatten?
Ik kan een OCR pipeline toevoegen om tekst te extraheren uit gescande en op afbeeldingen gebaseerde PDFs voordat ze worden verwerkt voor AI zoek- en chatfuncties.
Geeft mijn AI chatbot antwoorden die niet echt in mijn documenten staan. Kun je dat oplossen?
Ja. Ik kan een RAG pipeline ontwerpen met betere document chunking, retrieval, metadata en bronvermelding om unsupported antwoorden te verminderen.
Kan de chatbot me laten zien waar een antwoord vandaan komt?
Ja. Het systeem kan broninformatie teruggeven zoals de naam van het document, paginanummer, sectie of de opgehaalde tekst naast het antwoord.
Ik heb duizenden documenten. Kunnen ze allemaal door AI doorzocht worden?
Ja. Ik kan een schaalbare ingestuurde, embedding en vector-search architectuur ontwerpen voor grote documentcollecties.
Mijn gescande documenten bevatten tabellen, kolommen of ongewone lay-outs. Werkt OCR dan nog?
Deze lay-outs kunnen problemen veroorzaken bij de extractie. Ik kan preprocessing en validatiestappen ontwerpen om veelvoorkomende OCR-fouten te behandelen en de kwaliteit van de geëxtraheerde inhoud te verbeteren.
