Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD
Gegevensingenieur
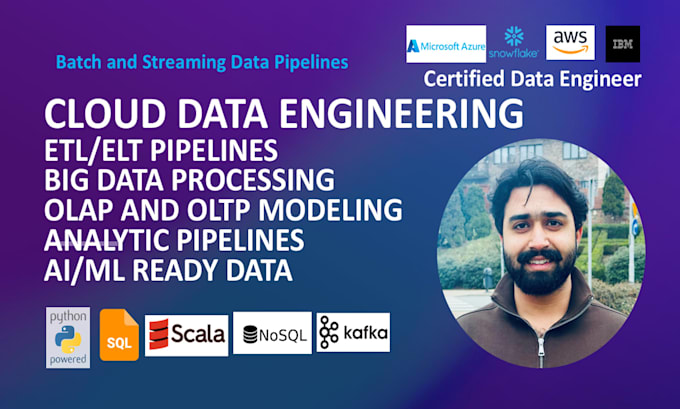
Heb je een Senior Data Engineer nodig voor schaalbare ETL/ELT pipelines, Big Data verwerking, Data Warehousing of Lakehouse architecturen?
Ik ben Muhammad Ahmed, een Data Engineer met meer dan 4 jaar ervaring in het bouwen van enterprise-grade data platforms op AWS, Azure, GCP en Snowflake ecosystemen.
Diensten die ik aanbied:
Technologieën:
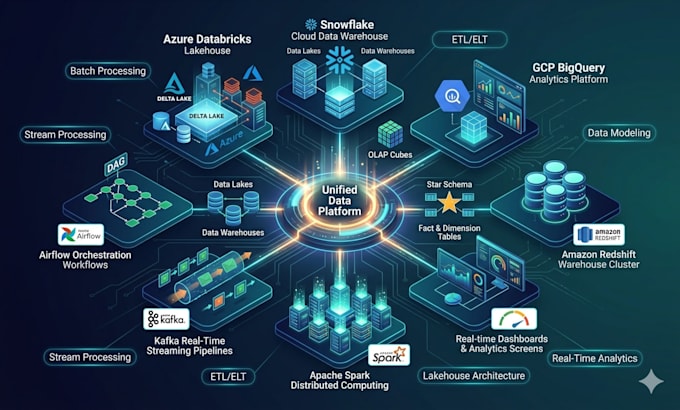
Azure Databricks, Snowflake, GCP BigQuery, Amazon Redshift, Apache Spark, PySpark, Kafka, Airflow, DBT, Snowflake SQL, SparkDF, PostgreSQL, AWS, Docker, Python, SQL.
Ik ontwikkel schaalbare, betrouwbare en cloud-native data engineering oplossingen voor analytics, rapportage, automatisering en real-time verwerking. En lever AI/ML en analytics gereed data.
Data engineering, ETL, ELT, Big Data, PySpark, Airflow, Kafka, Snowflake, Databricks, Data Warehouse, Redshift, BigQuery.
Warehouse Platform:
Snowflake
•
BigQuery
•
Databricks
Projecttype:
Nieuwbouw
Automatische vertaling
Welke cloudplatforms ondersteunt u?
Ik werk met AWS, Azure, GCP, Snowflake, Databricks, Amazon Redshift en BigQuery.
Bouw je batch- en streaming pipelines?
Ja. Ik ontwikkel batch pipelines met Apache Spark en streaming oplossingen met Kafka en Spark Streaming.
Kun je Data Warehouse en Lakehouse architecturen ontwerpen?
Ja. Ik ontwerp schaalbare Data Lakes, Data Warehouses en Lakehouse systemen met Medallion Architecture en moderne cloud platforms.
Welke orchestratie tools gebruik je?
Apache Airflow, Snowflake Tasks / Scheduled Jobs en cloud-native scheduling oplossingen.
Voer je datamodellering uit?
Ja. Ik werk met Star Schema, Snowflake Schema, Dimensions, Fact Tables, OLAP en OLTP modellering.
Welke technologieën gebruik je voor data verwerking?
PySpark, Spark SQL, DBT, Snowflake SQL, SparkDF, Python, SQL, Kafka en cloud-native verwerkingshulpmiddelen.
Kun je bestaande pipelines optimaliseren?
Ja. Ik kan de prestaties, schaalbaarheid, kostenoptimalisatie en betrouwbaarheid van bestaande data engineering systemen verbeteren.