Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD
AI-ingenieur LLM-fijn afstemming met LoRA en QLoRA
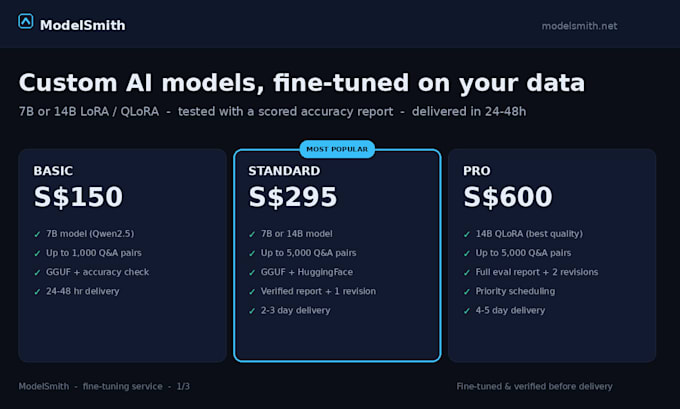
Ik stem 7B- en 14B-AI-modellen af op jouw data. Geen prompt-sjablonen — echte, fijn afgestemde LLMs getraind op jouw vragen en antwoorden, getest voor levering en geleverd in het formaat dat jij nodig hebt.
Wat ik doe:
- LoRA / QLoRA-fijn afstemmen van 7B- of 14B-modellen (Qwen2.5 als standaard)
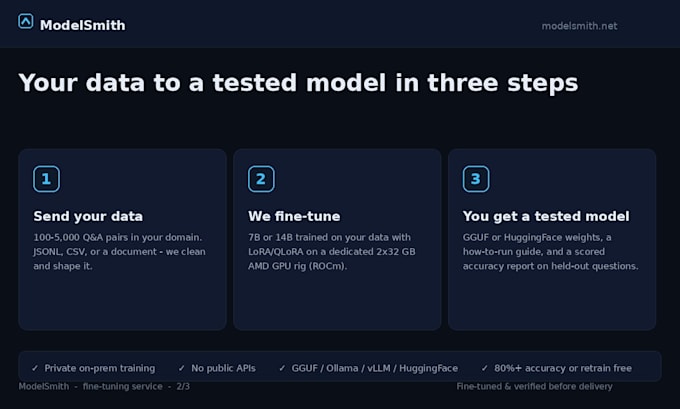
- Getraind op 100 tot 5.000 van jouw eigen Q&A-paren
- Geverifieerd met een accuraatheidsrapport op hold-out-vragen
- Levert als GGUF (Ollama, llama.cpp) of HuggingFace (vLLM, Transformers)
Waarom het anders is:
De meeste gigs geven je een bestand en zeggen succes. Ik test het eerst. Elk model wordt geleverd met een accuraatheidsrapport op jouw eigen hold-out-data - 80% of hoger, of ik hertrain gratis.
Privacy:
Trainingen draaien op een privé 2x32 GB GPU-setup. Jouw data gaat nooit naar een publieke API en wordt verwijderd bij levering tenzij jij wilt dat ik het bewaar.
Snelheid:
Een 7B LoRA-train duurt minder dan een uur rekentijd. De meeste projecten leveren in 24 tot 48 uur.
Stuur mij jouw dataset en ik maak binnen enkele dagen een geteste model klaar.


Programmeertaal:
Python
•
Pytorch
•
Overige
Datatype:
Tekst
•
Tabular Data
•
Overige
AI engine:
Llama
•
PyTorch
•
Overige
Automatische vertaling
Welk model gebruik je?
Qwen2.5-7B-Instruct standaard voor de 7B-tier. Qwen2.5-14B-Instruct voor 14B. Mistral- en Llama-modellen op verzoek beschikbaar.
Wat moet ik je sturen?
100 tot 5.000 Q&A-paren in elk formaat: JSONL, CSV of zelfs een document. Ik ruim het op en structureer het.
Hoe verschilt dit van een prompt-sjabloon of systems prompt?
Een prompt-sjabloon instructs een generiek model. Een fijn afstemmen verandert de modelgewichten zodat het jouw antwoorden native kent. Betere nauwkeurigheid, jouw stem, minder prompt overhead.
Zijn mijn gegevens veilig?
Ja. De training draait op een privé lokale 2x32 GB GPU-set, geen publieke API. Ik verwijder de dataset bij levering tenzij jij wilt dat ik deze bewaar.
Wat krijg ik precies?
Modelgewichten (GGUF en/of HuggingFace), een handleiding met exacte commando’s voor jouw runtime (Ollama, llama.cpp, vLLM) en een accuraatheidsrapport.
Wat als het model niet goed werkt?
Standaard bevat 1 gratis revisie, Premium 2. Als de hold-out-evaluatie jouw accuraatheidsdoel mist, hertrain ik kosteloos.
Hoe lang duurt de levering?
7B: 24-48 uur. 14B: 2-5 dagen. Turnaround start zodra jouw dataset bevestigd is.
Heb ik mijn eigen GPU of hardware nodig?
Nee. Ik doe alle training op mijn rig. Jij hebt alleen hardware nodig om het eindmodel te draaien (elke CPU kan een 7B GGUF draaien, of gebruik Ollama).