Door categorieën bladeren
Nederlands
$
USD
Koppel je AI aan Fiverr
Bedrijf- en engineeringstudent
Heb je honderden rapporten, pdf’s of scans en geen betrouwbare cijfers uit ze?
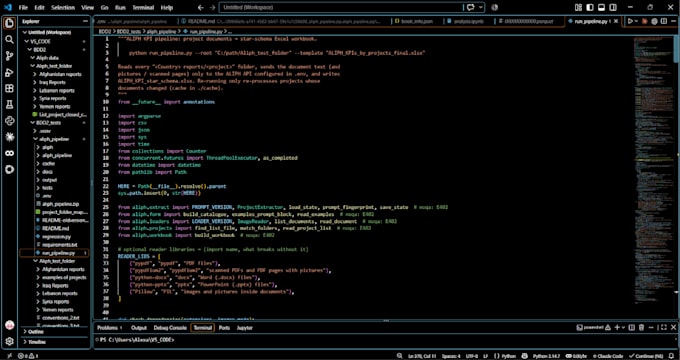
Ik bouw een Python-pipeline die je documenten (PDF, gescande PDF, Word, Excel, JSON, afbeeldingen) leest en omzet in een schone database die je kunt queryen. Je kunt het gebruiken voor KPI-rapportage, een donor- of bestuursrapport, of als data-bron voor een website.
Wat je krijgt
Hoe ik fouten laag houd
Quotes worden in de code vergeleken met de brontekst. Wiskundige berekeningen en bedrijfsregels worden in de code geverifieerd. Een tweede, onafhankelijke lezing door het model wordt vergeleken met de eerste. Een kleine steekproef wordt naar een mens gestuurd.
Jouw data blijven privé. De inhoud gaat alleen naar het eindpunt dat jij kiest. Sleutels worden nooit in bestanden opgeslagen. Ik kan een NDA tekenen.
Stuur me een korte beschrijving en
Automatische vertaling
Hoe nauwkeurig is het?
Ik meet nauwkeurigheid op een referentieset die jij helpt controleren, en ik rapporteer het cijfer. Ik beloof geen getal van tevoren.
Wat als mijn bestanden incompleet zijn?
Mijn ontwerp gaat om met incomplete data. Leemten blijven zichtbaar en het totaal is een bewezen minimum met dekking.
