Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD
Automatische vertaling
Heb je moeite om AI echt voor je bedrijf te laten werken?
Het integreren van een Large Language Model is niet alleen het aanroepen van een API. Algemene setups kampen vaak met hallucinaties, trage responsetijden, slechte data-ophaling en gebrek aan domeinspecifieke kennis, waardoor ze tekortschieten in de praktijk.
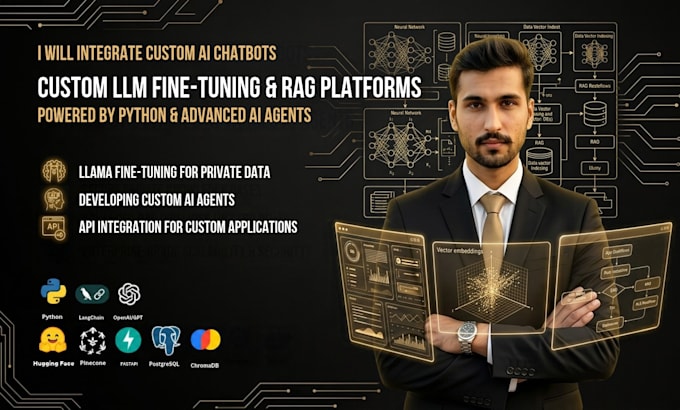
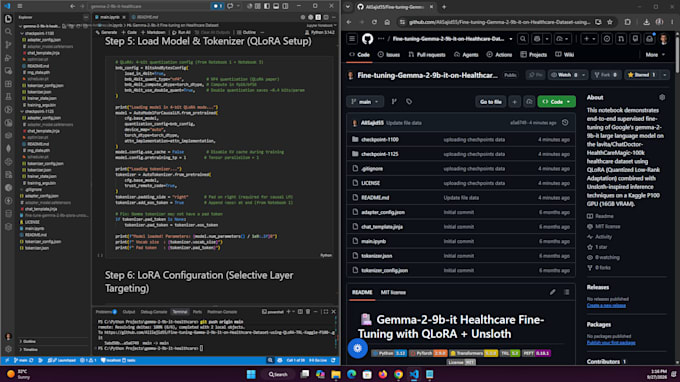
Ik ben een AI Engineer die gespecialiseerd is in op maat gemaakte LLM-integratie, geavanceerde RAG-architecturen en model finetuning, en zet complexe AI-capaciteiten om in productieklare software.
Wat ik aanbied:
Stop met genoegen nemen met generieke AI-uitvoer. Laten we een snelle, precieze AI-oplossing voor jouw bedrijf bouwen.
Stuur me een bericht om je idee te bespreken.
AI Engineer Deep Learning Computer Vision GEN AI Agentic AI
Talen
Automatische vertaling
Automatische vertaling
Welke LLM-modellen ondersteun je voor integratie en finetuning?
Ik werk met zowel commerciële APIs zoals OpenAI (GPT-4o), Claude en Gemini, als open-source LLMs zoals Llama 3, Mistral en Falcon voor op maat gemaakte finetuning en hosting.
Wat is het verschil tussen LLM-integratie en finetuning?
Integratie koppelt bestaande voorgetrainde modellen (zoals OpenAI) aan je app via APIs voor algemene taken. Finetuning houdt in dat je een open-source model traint op je eigen dataset zodat het jouw domeinkennis en interne richtlijnen direct leert.
Moet ik mijn eigen API-sleutels of serverinfrastructuur aanleveren?
Ja, je moet je eigen API-sleutels (bijvoorbeeld OpenAI, Anthropic) of hostinginfrastructuur (AWS, GCP, RunPod) voor model deployment aanleveren. Ik kan je echter begeleiden bij het efficiënt opzetten hiervan.
Kun je een op maat gemaakt RAG-systeem bouwen met private document search?
Absoluut! Ik kan een Retrieval-Augmented Generation (RAG) pipeline opzetten met LangChain, LlamaIndex en vector databases (zoals Pinecone, Supabase of Qdrant) zodat je model nauwkeurig vragen uit je private documentatie of kennisbank beantwoordt.
Ontvang ik de volledige source code en documentatie?
Ja, alle pakketten bevatten schone, goed gedocumenteerde broncode samen met volledige documentatie en instructies over hoe je de applicatie kunt uitvoeren, testen en implementeren.