Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD
Senior Software Engineer POS, ERP en AI-gestuurde web- en mobiele oplossingen
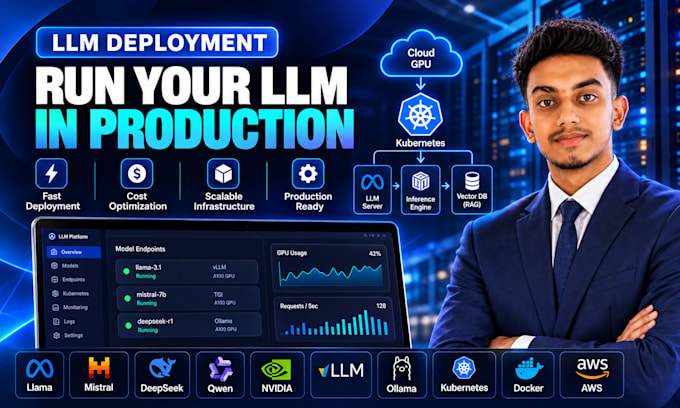
Wil je je LLM snel, geoptimaliseerd en kostenefficiënt naar productie brengen?
Je bent op de juiste plek!
Ik deploy en configureer open-source LLMs op GPU cloud servers en Kubernetes, met afgestemde inference engines voor snelle reacties en lagere GPU-kosten.
Wat ik aanbied:
Tech stack:
Inference: vLLM || TGI || Ollama || NVIDIA Triton || TensorRT-LLM || llama.cpp || SGLang
Modellen: Hugging Face || Llama || Mistral || Qwen || DeepSeek
Cloud & GPU: AWS || Google Cloud || Azure || RunPod || Lambda Labs
Containers: Docker || Kubernetes || Helm
Monitoring: Prometheus || Grafana
Waarom voor mij kiezen?
Laten we je LLM vandaag nog live zetten!
Tools:
Kubernetes
•
Docker
•
Amazon EKS
•
Google Kubernetes Engine
Frameworks:
Npm
•
Terraform
•
Ansible
•
Pop
•
Crossplane
Programmeertaal:
Bash
•
C
•
Go
•
Java
•
JavaScript
•
Lua
•
PHP
•
Python
•
Ruby
•
Golang
Expertise:
Installatie
•
Debuggen
•
Configuratie
Automatische vertaling
Welke LLMs kun je inzetten?
Elke open-source model van Hugging Face, inclusief Llama, Mistral, Qwen, DeepSeek, Gemma, en Phi, evenals fijn-getunede of aangepaste modellen die jij aanlevert.
Wat omvat de configuratie van inference engine?
Het opzetten en afstemmen van vLLM, TGI, Triton of Ollama voor jouw model: GPU-geheugen, batching, contextlengte, KV-cache, tensor parallelisme en quantization, zodat je snellere reacties krijgt tegen lagere kosten.
Welke inference engine moet ik gebruiken?
vLLM voor API's met hoge throughput, TGI voor Hugging Face modellen, Triton of TensorRT-LLM voor maximale NVIDIA GPU-prestaties, en Ollama of llama.cpp voor kleinere of CPU-setup. Ik adviseer je de beste keuze.
Kan je mijn GPU-kosten verlagen?
Ja. Door quantization (AWQ, GPTQ, GGUF), batching en juiste GPU-grootte kan ik vaak hetzelfde model draaien op goedkoper hardware met vergelijkbare kwaliteit.
Werkt de API zoals die van OpenAI?
Ja. Ik kan een API-endpoint opzetten die compatibel is met OpenAI, zodat je je bestaande app kunt switchen van OpenAI naar je eigen LLM door alleen de basis-URL en API-sleutel te veranderen.
Wie betaalt voor GPU- en cloudkosten?
GPU- en hostingkosten worden door de provider (AWS, GCP, Azure, RunPod, etc.) aan jouw account gefactureerd. Ik help je de meest kosteneffectieve GPU voor jouw model en verkeer te kiezen.
Zijn mijn model en data privé?
Ja. Je LLM draait op je eigen servers, dus prompts en data gaan nooit naar derde partijen. Ik beveilig ook de endpoint met API-sleutels, SSL en firewallregels. Ik kan een NDA ondertekenen indien nodig.
Wat moet ik aanleveren voordat we beginnen?
Het model dat je wilt (of je wensen), toegang tot je cloud- of GPU-account, verwacht verkeer, en elk domein dat je wilt gebruiken. Als je twijfelt, bied ik een gratis consult aan.
Kan je een model deployen dat ik heb fijn-getuned?
Ja. Deel je modelgewichten of Hugging Face repo, en ik deploy en optimaliseer het met de juiste inference engine.
Weet je niet zeker welk pakket bij jouw project past?
Stuur me een bericht voordat je bestelt. Ik beoordeel je model en verkeer en adviseer je over het juiste pakket of stuur een aangepaste offerte.
