Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD



Automatische vertaling
Geeft je RAG chatbot verkeerde antwoorden, mist het het juiste bewijs of klinkt het zelfverzekerd terwijl de bron dat niet ondersteunt?
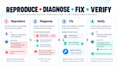
Ik test systematisch de route van vraag -> retrieval -> context -> antwoord -> citaat.
Ik controleer eerst wat je systeem daadwerkelijk kan meten. Daarna bouw ik een baseline, identificeer ik de eerste falende fase, pas ik de afgesproken verbetering toe en voer ik dezelfde testcases opnieuw uit.
Je kunt ontvangen:
In een onafhankelijke audit van 50 cases met SourceChat waren 39 van de 50 eindantwoorden correct. Bij dezelfde 45 beantwoorde cases steeg het aantal volledig correcte antwoorden van 26/45 naar 34/45 en bereikte de exact-ID retrieval 8/8 zonder de bestaande index van 10.736 chunks te herbouwen.
Python/FastAPI, Node.js/TypeScript, LangChain/custom RAG, Pinecone, pgvector, OpenAI en Gemini.
Stuur me een bericht voordat je bestelt met je stack en 3 falende voorbeelden.
RAG and Full Stack AI Developer
Talen
Automatische vertaling
Automatische vertaling
Heb ik een bestaande RAG chatbot nodig?
Ja. Deze dienst is vooral bedoeld voor het diagnosticeren en verbeteren van een bestaande RAG chatbot of retrieval pipeline. Als je een nieuwe RAG-assistent vanaf nul wilt laten bouwen, gebruik dan een van mijn RAG ontwikkelingsgigs.
Kun je garanderen dat er geen hallucinaties zijn?
Geen enkel verantwoord RAG-systeem kan garanderen dat een LLM nooit een verkeerd antwoord geeft. Ik richt me op het verbeteren van retrieval, grounding, citaties en gedrag bij onvoldoende bewijs, en op het meten van het systeem met testvragen.
Welke RAG-problemen kan je onderzoeken?
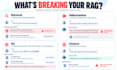
Voorbeelden zijn irrelevante retrieval, ontbrekende documenten, zwakke chunking, metadata filters, niet gevonden exacte identifiers, slechte contextopbouw, citatieproblemen en unsupported antwoorden.
Met welke technologieën werk je?
Mijn belangrijkste stack is Node.js/TypeScript, LangChain, PostgreSQL/pgvector en OpenAI. Ik kan ook aangepaste RAG-architecturen beoordelen waar de code en componenten toegankelijk zijn.
Wat heb je van me nodig?
Ik heb een beschrijving van het probleem nodig, je huidige architectuur of repository, voorbeeld documenten/data indien nodig, en voorbeelden van vragen waarbij het systeem verkeerd presteert.
Meet je de verbetering?
Standaard en Premium kunnen een evaluatieset en voor/na tests bevatten, zodat verbeteringen gebaseerd zijn op daadwerkelijke testcases in plaats van subjectieve indrukken.
Kun je hybride zoeken implementeren?
Ja, wanneer het passend is voor het probleem. Dit kan semantisch retrieval combineren met zoekwoord- of full-text zoeken, vooral wanneer gebruikers zowel natuurlijke taal zoekopdrachten als exacte identifiers nodig hebben.


