Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD
Python automatisering, data pipelines en Excel oplossingen, financiële achtergrond
Je data komt binnen in bestanden, APIs en exports die niet met elkaar overeenkomen, en iemand probeert dat elke maand handmatig aan elkaar te knopen.
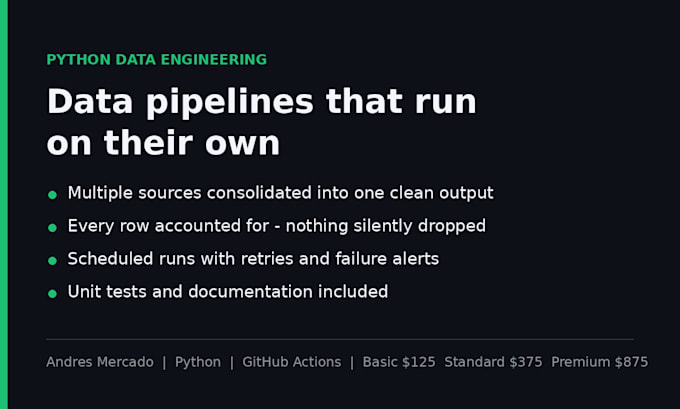
Ik bouw dat in plaats daarvan als een pipeline: een herhaalbare taak die je bronnen binnenhaalt, ze normaliseert naar één schema en de output produceert die je echt nodig hebt - volgens een schema, zonder dat iemand er constant bij hoeft te blijven.
Hoe ik werk:
Elke rij uit je bronnen wordt gecontroleerd. Rijen die niet correct worden gemapt, worden GEMARKERD, nooit stilletjes verwijderd. Je krijgt een reconciliatie die de aantallen vóór en na laat zien.
Foutgevallen worden eerst afgehandeld: retries bij tijdelijke fouten en een waarschuwing wanneer een bron niet beschikbaar is, in plaats van een stil lege rapportage.
Inloggegevens staan in omgevingsgeheimen die jij beheert, nooit in de code.
Tests zijn inbegrepen, zodat een provider die zijn formaat wijzigt, wordt opgemerkt in plaats van drie weken later ontdekt te worden.
Ik bouw deze pipelines met CI, type checking, geautomatiseerde deployment en geplande uitvoering als standaard. Jouw levering bevat de project-specifieke code, de tests en de documentatie, binnen de scope van jouw pakket.
Stuur me een bericht met je bronnen en hoe de output eruit moet zien, en ik vertel je eerlijk of dit geschikt is voordat je bestelt.
Bestemmingsplatform:
Overige
Tools & platforms:
Overige
Automatische vertaling
Met welke gegevensbronnen kunt u werken?
CSV, Excel, JSON, XML, SQL databases (Postgres, MySQL, SQLite) en REST API's. Als jouw bron iets anders is, stuur me eerst een bericht en ik vertel je eerlijk wat mogelijk is.
Kan ik het daarna zelf uitvoeren?
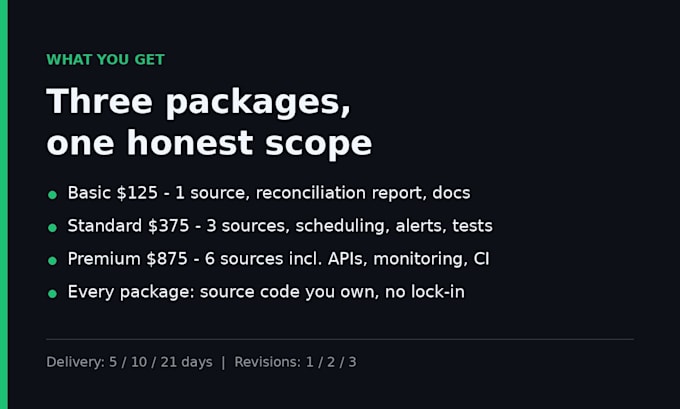
Ja. Je krijgt de source code en setup documentatie, en het Premium pakket bevat een overdrachtssessie: een geplande call van maximaal 45 minuten. Het punt is dat je niet afhankelijk bent van mij.
Wat gebeurt er met rijen die niet in het schema passen?
Ze worden gemarkeerd met een reden, nooit verwijderd. Stil verlies van rijen is de meest voorkomende en schadelijke fout in dit soort werk, dus ik reconcileer tellingen voor en na en laat je het verschil zien.
Heb je toegang nodig tot onze productie systemen?
Nee, en dat zou ik liever niet hebben. Exports of een read-only credential zijn voor bijna alles voldoende.
Kan het automatisch op een schema draaien zonder dat ik iets doe?
Ja, vanaf het Standard pakket. Het draait op een schema in je eigen account - meestal GitHub Actions, dus je hoeft geen nieuw abonnement te kopen. Ik bouw en test de geplande taak en geef je de configuratie en een setup gids, zodat er niets afhankelijk is van mij.
Wat als een bron na levering van formaat verandert?
De tests vangen dat op. Binnen de revisieperiode repareer ik het; daarna kan ik een kleine onderhoudsopdracht geven.