Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD

Level 2


Automatische vertaling
CUSTOM LLM FINE-TUNING
Algemene AI-modellen kunnen hallucineren of falen in jouw bedrijfsprocessen. Fijn afstemmen met jouw eigen data, formatting en domeinkennis.
LEVERINGEN & SNELHEID
DE OPLOSSING
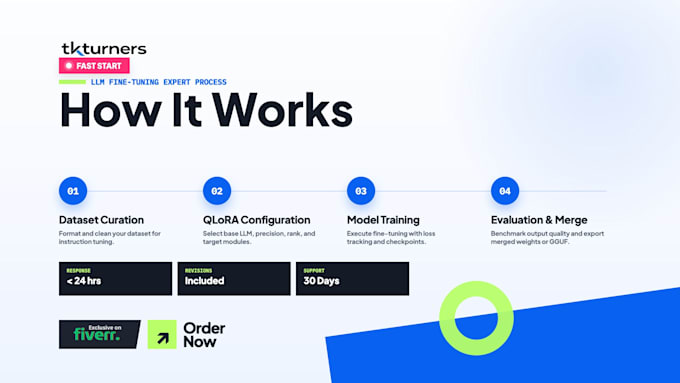
We bouwen schone instructiedatasets, optimaliseren rank/alpha parameters, en finetunen modellen voor betere domeinprestaties en lagere inferencekosten.
WAAROM TKTURNERS
Full-stack AI-engineers die productieklaar modellen en workflow automatisering leveren, afgestemd op jouw bedrijfsbehoeften.
<strong KWALITEITSGARANTIE
Elk model wordt getest tegen afgesproken test prompts. Als de resultaten niet aan de target metrics voldoen, trainen we opnieuw zonder extra kosten.
GRATIS AI-AUDIT
Stuur een bericht voorafgaand aan je bestelling voor een gratis 15-minuten dataset audit & modelarchitectuur advies.
Senior Software Engineer
Level 2
Talen
Automatische vertaling
Automatische vertaling
Waarom moet ik u een bericht sturen voordat u bestelt?
Vóórdat we beginnen, kunnen we je datasetgrootte evalueren, compatibiliteit met de basis model controleren (bijvoorbeeld Llama 3, Mistral), en je compute-behoeften bevestigen zodat je precies het juiste pakket krijgt.
Welke basis LLM-architecturen ondersteunt u voor fine-tuning?
We ondersteunen Llama 3/3.1, Mistral, Mixtral, Gemma 2, Qwen 2.5, DeepSeek, Falcon en elk custom open-weights model gehost op Hugging Face.
Wat is het verschil tussen LoRA en QLoRA?
LoRA traint low-rank adapter matrices om een model efficiënt aan te passen. QLoRA quantiseert het basis model tijdens training naar 4-bit precisie, wat GPU VRAM-vereisten drastisch vermindert terwijl de nauwkeurigheid behouden blijft.
Wie betaalt de GPU compute- en cloudinfrastructuurkosten?
Computekosten (RunPod, Lambda Labs, Google Colab Pro, of Hugging Face Inference Endpoints) worden rechtstreeks door de klant betaald. We adviseren je over de meest kosteneffectieve GPU-opstelling.
In welk formaat moet mijn dataset worden aangeleverd?
Je kunt je data aanleveren in JSON, JSONL, CSV of ruwe tekst. Wij reinigen, valideren en converteren het naar standaard instructieformaten zoals Alpaca, ShareGPT of ChatML.
Welke exacte deliverables ontvang ik bij voltooiing van het project?
Je ontvangt getrainde LoRA adaptergewichten, de samengevoegde standalone model (indien aangevraagd), GGUF-quantum bestanden voor Ollama/LM Studio, test scripts en evaluatiemetrics.
Kun je het fijn afgestemde model implementeren op een API of privé cloud?
Ja. We kunnen je getrainde model implementeren op Hugging Face Dedicated Endpoints, RunPod serverless, vLLM, Ollama, of een aangepaste FastAPI backend op AWS/GCP.
Welke derde partij API- of platformtoegang heb je nodig?
We kunnen lees/schrijftoegang nodig hebben tot je Hugging Face account (access token) en je gekozen GPU cloud platform (RunPod, Lambda Labs, of AWS) via API-sleutels of tijdelijke credentials.
Hoe ga je om met revisies en benchmark prestaties?
Elke laag bevat revisies om leersnelheden, epochs of rank/alpha parameters af te stemmen. We evalueren je model tegen validatie-sets om de kwaliteit te verifiëren.
Biedt u ondersteuning en onderhoud na oplevering?
Ja, wij bieden doorlopende onderhouds- en retainer ondersteuning voor periodieke dataset-inname, model retraining en cloud inference schaalvergroting.