Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD

Automatische vertaling
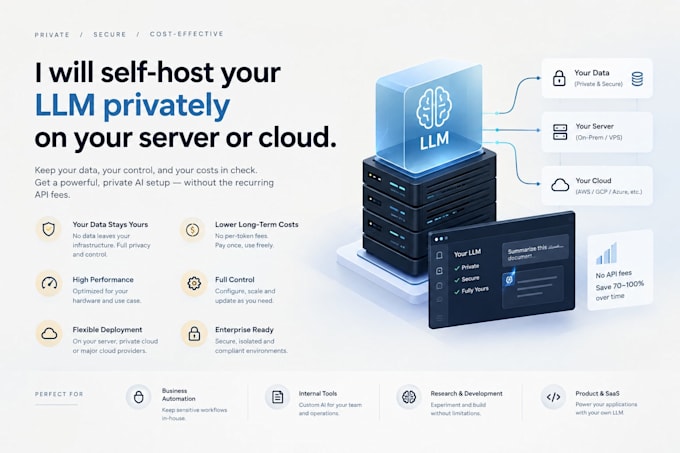
Ik host je je LLM privé op je eigen server of cloud
Je LLM via een API van een derde partij laten draaien betekent dat je prompts en data via andermans servers gaan. Als je data privacy, voorspelbare kosten of een offline/air gapped model nodig hebt, is zelf-hosting de oplossing. Ik zet het volledig voor je op.
Ik zet open-weight modellen (Llama, Mistral, Qwen, DeepSeek, of je eigen getrainde model) op je eigen VPS, dedicated server of cloud GPU-instance (AWS, Vultr, RunPod, Lambda Labs) en maak ze toegankelijk via een schone OpenAI-compatibele API-endpoint die je direct in je app kunt gebruiken.
Wat je krijgt:
Ik heb productie-infrastructuur opgezet op AWS (ECS, EC2, IAM) en eerder gewerkt met GPU-gehoste Kubernetes. Dit is niet mijn eerste server.
AI Engineer and Automation Specialist I LangChain, RAG I React, Node, DevOps
Talen
Automatische vertaling
Automatische vertaling
Heb ik mijn eigen GPU nodig?
Nee — ik kan je helpen bij het provisionen van een cloud GPU-instance als je er geen hebt (kosten los van de gig prijs).
Kun je het model fine-tunen?
Dat is een aparte dienst — deze gig dekt de deployment/hosting van een bestaand of open-weight model.
Is mijn data echt privé?
Ja — zodra het is gedeployed, draait alle inference op jouw infrastructuur; er wordt niets naar een API van derden gestuurd.
