Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD
Financiële modellering, DCF, Power BI, churn voorspelling
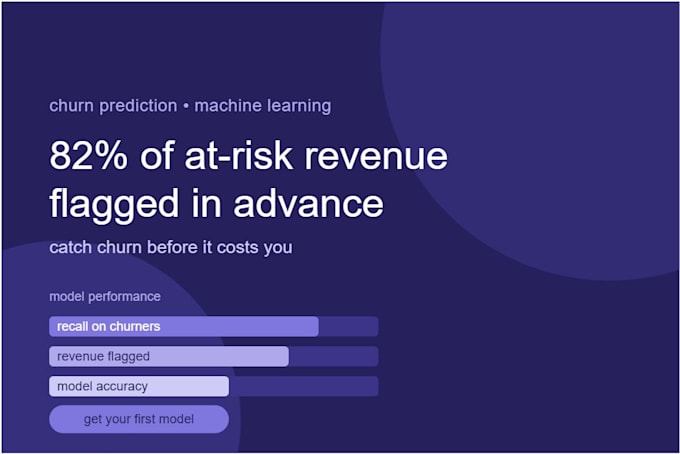
Het stilletjes verliezen van abonnees kost inkomsten en de meeste bedrijven merken het pas als de klant al weg is.
Ik bouw machine learning modellen die aangeven welke klanten op het punt staan te vertrekken voordat het gebeurt, zodat je nog kunt ingrijpen met retentieaanbiedingen terwijl er nog tijd is.
Op een realistische telecom dataset (meer dan 7.000 klanten) gaf mijn model correct aan 82% van de inkomsten die op het spel stonden, ter waarde van meer dan $1,7 miljoen per jaar als het werd opgeschaald naar een abonnementenbedrijf met 10.000 klanten. Het model laat ook zien waarom klanten vertrekken (contracttype, duur, prijs), zodat je niet alleen een voorspelling krijgt, maar ook een reden.
Wat je krijgt:
Of je nu een SaaS-product, een abonnementenbox, een telecomdienst of een ander bedrijf met terugkerende inkomsten runt, als je klanten verliest en niet weet waarom, vertelt dit je dat.


Programmeertaal:
Python
Frameworks:
Scikit-learn
•
Panda
API's:
Google Cloud Vision API
Tools:
Jupyter-notitieboek
•
Colab
Automatische vertaling
Moet ik mijn eigen klantgegevens aanleveren?
Niet per se — je kunt je eigen klantdataset (CSV/Excel) delen voor een volledig op maat gemaakt model, of ik kan een representatieve sample dataset gebruiken om de aanpak te demonstreren als je nog niet klaar bent om echte data te delen. Hoe dan ook, de oplevering bevat hetzelfde model, risicoscores en rapport.
In welk formaat ontvang ik de resultaten?
Je krijgt een gerangschikte lijst van klanten op basis van churn risico (Excel/CSV), een geschreven rapport dat de belangrijkste drijfveren van churn uitlegt in eenvoudige zakelijke termen, en — afhankelijk van je pakket — een schatting van revenue-at-risk in dollar.
Hoe nauwkeurig is het model?
Nauwkeurigheid hangt af van je data, maar op een benchmark dataset gaf mijn model 82% van de riskerende revenue aan. Ik deel precisie, recall en nauwkeurigheid voor jouw data — de belangrijkste metric voor churn is de omzet die wordt opgevangen, niet alleen de algehele nauwkeurigheid.
Kun je het model implementeren of verbinden met mijn live systeem?
Momenteel niet als onderdeel van deze dienst — dit levert een getraind model en analyse op basis van de data die je aanlevert, niet live implementatie of API-integratie. Ik bespreek dat graag als een maatwerk vervolg indien nodig.
Welke data heb je minimaal nodig?
Klantgegevens met een churn/niet-churn uitkomst en relevante features — zoals duur, contracttype, factuurbedrag, gebruikspatronen, supportinteracties. Hoe meer relevante historie je hebt, hoe sterker het model.
Hoe lang duurt het?
Levertijd staat vermeld per pakket (3/5/7 dagen), maar stuur me eerst een bericht met de grootte en het formaat van je dataset zodat ik de timing kan bevestigen voordat je bestelt — zeer grote of rommelige datasets kunnen een maatwerk offerte vereisen.
Bieden jullie revisies aan?
Ja, het aantal dat is inbegrepen hangt af van je pakket — zie de details hierboven. Extra revisies kunnen als gig extra worden toegevoegd.