Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD
Backend- en AI-ontwikkelaar, NodeJS, PostgreSQL, RAG-chatbots
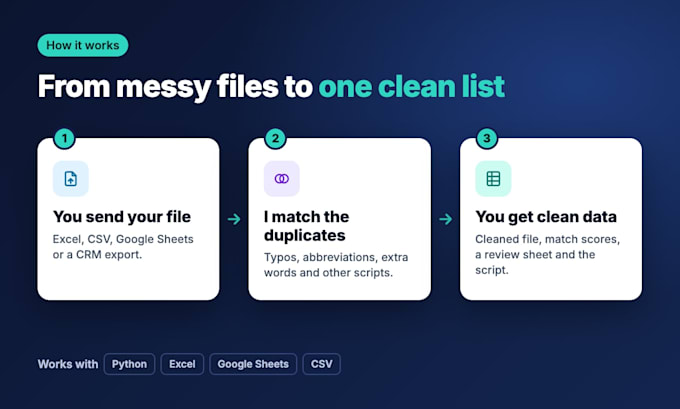
Dubbele klanten, dezelfde onderneming vijfmaal opgeschreven, rommelige adressen? Ik maak je data schoon en voeg de duplicaten samen, ook als namen tikfouten bevatten of woorden ontbreken.
Wat ik voor je kan doen:
- Exacte en near-duplicate detectie (fouten, afkortingen, extra woorden zoals Pvt Ltd)
- Namen in Hindi en andere Indiase schrijfsystemen gekoppeld aan Engelse namen
- Vergelijking over twee of drie bestanden of systemen
- Een vertrouwen-score voor elke match, plus een overzichtsblad voor twijfelsituaties
- Schoon bestand in Excel, CSV of Google Sheets
- Een herbruikbaar Python-script (Standard en Premium)
- Optionele automatische maandelijkse her-runs
Waarom ik: Tijdens de Amazon ML Challenge 2026 leidde ik een team dat bedrijfsgegevens matchte over drie rommelige bronnen zonder gedeelde ID, met een score van 0.979 F0.5 en zonder verkeerde merges. De code staat openbaar op mijn GitHub.
Stuur me een kleine steekproef (zelfs 20 rijen) en vertel wat jij als duplicaat beschouwt. Ik laat je weten hoe ik het aanpak.
Nog niet zeker? Begin met het Trial Clean-pakket voor maximaal 100 rijen en bekijk de resultaten eerst.
Jouw data blijft privé en wordt na levering verwijderd.
Automatische vertaling
Zijn mijn gegevens veilig?
Het wordt alleen voor jouw bestelling gebruikt, nooit gedeeld en na levering verwijderd.
Kun je namen in Hindi of andere schriften koppelen?
Ja. Ik heb eerder Devanagari, Tamil, Bengali en andere schriften aan Engelse namen gekoppeld.
Wat als ik niet zeker weet wat als duplicaat geldt?
Ik stuur je een steekproef van matches ter bevestiging voordat ik het volledige bestand verwerk.
Krijg ik het script?
Ja, in Standard en Premium kun je het zelf opnieuw uitvoeren.
Mijn bestand is groter dan 10.000 rijen. Kan je dat nog steeds doen?
Ja. Kies de extra rijen-optie voor elke extra 10.000 rijen of bericht me voor een maatwerkaanbieding bij zeer grote bestanden. Mijn matching-pipeline heeft miljoenen records verwerkt.