Door categorieën bladeren
Nederlands
$
USD
Koppel je AI aan Fiverr

Automatische vertaling
Verlaag de latentie van je model en verhoog de throughput met meetbare cijfers.
Typisch werk:
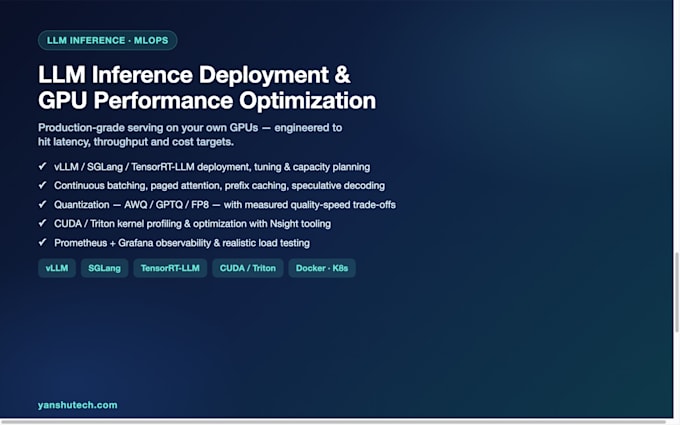
- Host je model met vLLM, SGLang of TensorRT-LLM, afgestemd op jouw GPU-vloot
- Continu indelen/ batching, gepagineerde aandacht, prefix-caching, speculatieve decoding
- Kwantisatie (AWQ / GPTQ / FP8) met een kwaliteit-versus-snelheidsverhouding die jij kunt verifiëren
- CUDA / Triton-profilerings met Nsight om echte knelpunten te vinden
- Docker / Kubernetes verpakking, Prometheus + Grafana dashboards, realistische load tests
Wat je krijgt: deploymentconfiguraties, benchmarkresultaten (p50/p95-latency, tokens/seconde, kosten per 1M tokens), een load-testrapport en een korte runbook die jouw team kan gebruiken.
Wat NIET inbegrepen is: GPU-hardware en clouduitgaven, modellicenties, betaalde externe diensten, 24/7 on-call ondersteuning. Alles draait op jouw infrastructuur.
17 jaar aan systeem- en ML-engineering; ik zet modellen in op klant-GPU's als onderdeel van mijn dagelijkse productwerk.
Stuur mij je modelgrootte, GPU-type en doelgetallen voordat je bestelt.
Talen
Automatische vertaling
Automatische vertaling
Werkt dit met mijn GPU en model?
Ja - A100, H100, L40S, RTX 4090 en elk Hugging Face-model. Ik doe een benchmark op jouw daadwerkelijke hardware voordat ik afstel, zodat je echte cijfers hebt voor jouw setup.
