Door categorieën bladeren
Nederlands
$
USD
Koppel je AI aan Fiverr
GIS- en Remote Sensing-expert voor InSAR en Google Earth Engine
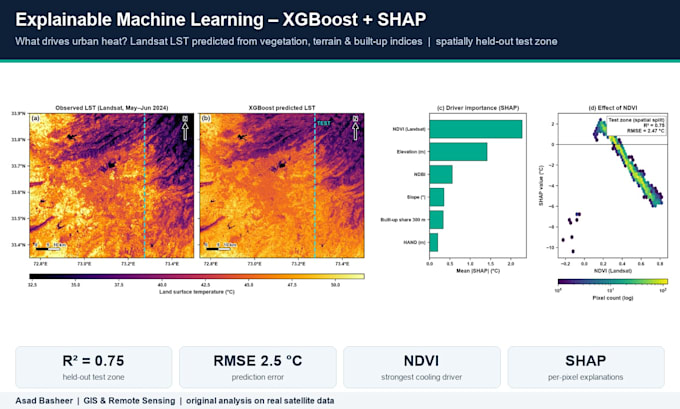
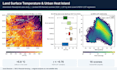
Machine learning voor satelliet- en milieu-data, gedaan op de manier zoals beoordelaars het verwachten. Ik ben een PhD-onderzoeker remote sensing aan de Tianjin University (MS CUG Wuhan) en bouw ML-modellen voor landdekking, water, warmte en hazard-kaartlegging. Voorbeeld in mijn galerij: XGBoost + SHAP die stadslandoppervlakte-temperatuur uitlegt (R2 0,75 op een ruimtelijk hold-out testzone).
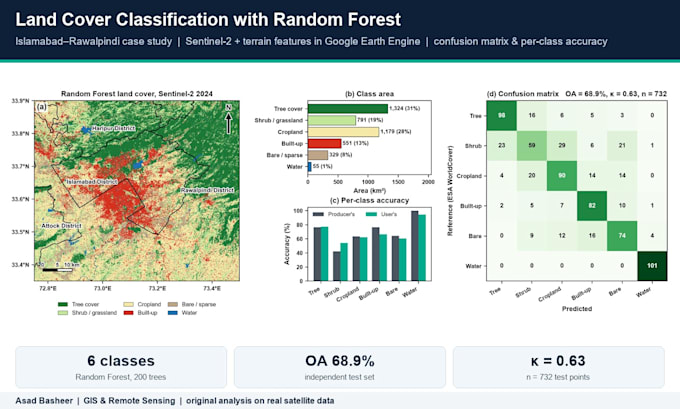
WAT IK DOEN: landdekking / gewas- / bosclassificatie (Random Forest, SVM, XGBoost, LightGBM); regressie en voorspelling (waterkwaliteit, chlorofyl-a, LST, luchtvervuiling, biomassa, bodemsvochtigheid, yield); explainable AI met SHAP en feature importance; ruimtelijke cross-validatie (geen gegevenslek); onzekerheidskaarten en voorspellingsintervallen; nauwkeurigheidsbeoordeling (OA, kappa, R2, RMSE).
GEGEVENS: Sentinel-1/2, Landsat, MODIS, VIIRS, GEDI, ERA5, in-situ en veldgegevens. Gereedschappen: Python (scikit-learn, XGBoost, SHAP, PyTorch), R, Google Earth Engine.
Je krijgt schone, gecommentarieerde code, kaarten en grafieken die klaar zijn voor een paper of rapport, en een korte methods write-up. Stuur me eerst een bericht met jouw data en doel en ik zal het juiste model voorstellen.

Programmeertaal:
Python
•
R
•
MATLAB
•
Colab
Frameworks:
Scikit-learn
•
keras
•
PyTorch
•
Panda
Tools:
Jupyter-notitieboek
•
Excel
•
Colab
•
RStudio
Automatische vertaling
Kan ik mijn eigen data aanleveren?
Ja. Stuur je CSV, rasters of shapefiles. Als je geen data hebt, kan ik de dataset opbouwen uit gratis satellietarchieven.
Worden de resultaten publieksbaar?
Ik volg goede praktijken voor papers: ruimtelijke cross-validatie, onafhankelijke testsets, onzekerheid en duidelijke methodetekst. Veel van mijn figuren komen uit peer-reviewed werk.