Door categorieën bladeren
Nederlands
$
USD
Koppel je AI aan Fiverr
AI en Data Science Specialist
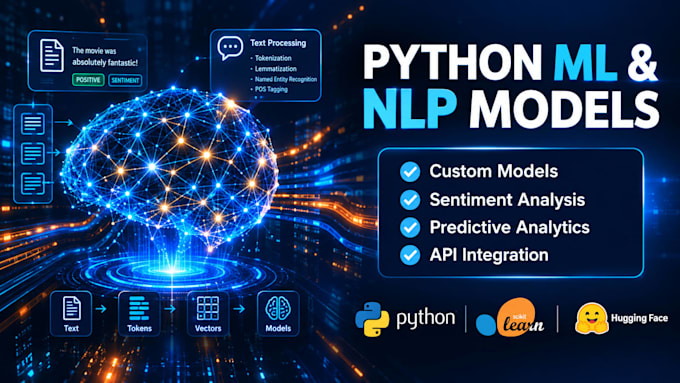
Ben je op zoek naar het omzetten van ruwe data naar slimme, schaalbare machine learning en natuurlijke taalverwerking oplossingen? Dan ben je hier aan het juiste adres!
Ik ben gespecialiseerd in het bouwen van maatwerk Machine Learning (ML), Natuurlijke Taalverwerking (NLP) en Predictive Models in Python die bedoeld zijn om complexe bedrijfsproblemen op te lossen, taken te automatiseren en duidelijke, uitvoerbare inzichten te leveren.
Wat ik voor jou kan doen:
Waarom voor mij kiezen?
Neem aub contact met mij op voordat je een bestelling plaatst
Programmeertaal:
Python
Frameworks:
Scikit-learn
•
keras
•
PyTorch
•
Panda
•
Overige
Tools:
Jupyter-notitieboek
•
Colab
Automatische vertaling
1. Wat heb je nodig om het project te starten?
Deel alsjeblieft je dataset (CSV, JSON, SQL of text), doel van het project, doelvariabelen en eventuele strakke deadlines of prestatie-eisen.
2. Welke ML- en NLP-modellen kun je bouwen?
Ik bouw traditionele ML-modellen (Classificatie, Regressie, XGBoost, Random Forest) én NLP-modellen (Sentimentanalyse, Tekstclassificatie, BERT/LLMs).
3. Kun je mijn data schoonmaken, voorbewerken en klaarmaken?
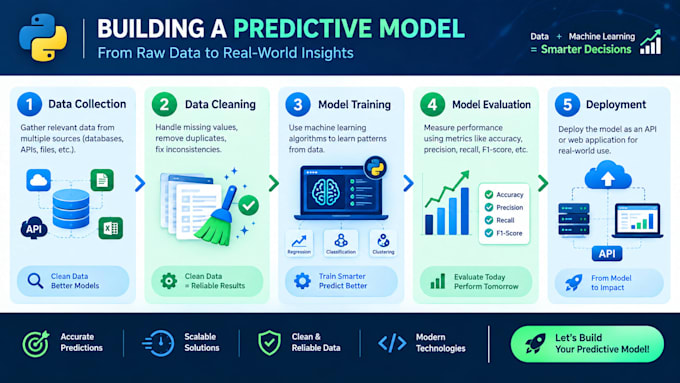
Ja, ik voer complete data preprocessing uit, inclusief het schoonmaken van ontbrekende waarden, feature engineering, teksttokenisatie en vectorisatie (embeddings/TF-IDF).
4. Krijg ik de complete Python-broncode?
Ja! Je ontvangt schone, goed commentaargebonden Python-broncode (Jupyter Notebook of .py-bestanden) bij elke bestelling.
5. Lever je model-evaluatie en deployment aan?
Ja, ik lever uitgebreide evaluatiestatistieken (Accuracy, F1-score, ROC-AUC) en kan modellen via REST API integreren of naar de cloud deployen.