Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD

Automatische vertaling
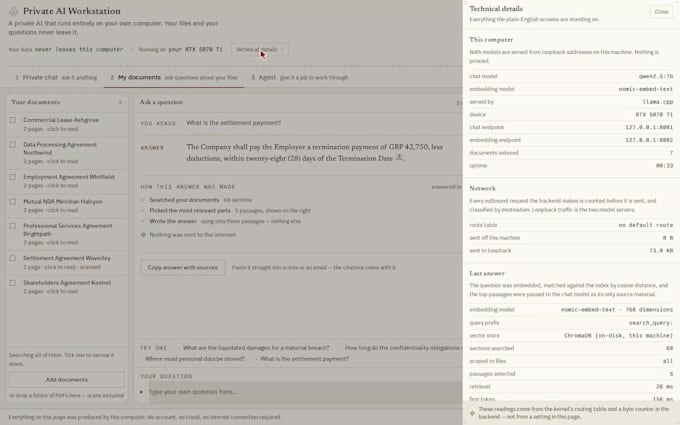
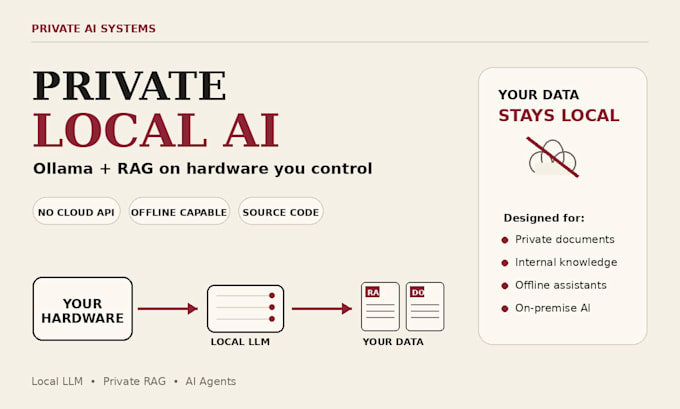
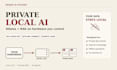
Run een private lokale LLM op hardware dat jij controleert, zonder prompts, documenten of gevoelige data naar externe model-API's te sturen.
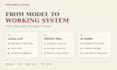
Ik bouw lokale AI-systemen met Ollama, llama.cpp, RAG, vector databases en aangepaste agent-workflows voor bedrijven en teams die privacy nodig hebben.
WAT IK KAN IMPLEMENTEREN
GOED VOOR
Interne knowledge bases, vertrouwelijke documenten, juridische/financiële operaties, privé-onderzoek, offline assistenten en teams die terugkerende cloud AI API-kosten willen vermijden.
Jouw systeem kan worden ingesteld om inference en document retrieval volledig op jouw machine of privé netwerk uit te voeren.
Stuur me een bericht voordat je bestelt met je OS, CPU, GPU/VRAM, RAM en gewenste gebruiksdoel, zodat ik het juiste model en pakket kan bevestigen.
Local AI Developer
Talen
Automatische vertaling
Automatische vertaling
Heb ik een krachtige computer nodig om dit te draaien?
Het hangt af van het model en de workload. Een dedicated NVIDIA GPU met voldoende VRAM wordt aanbevolen voor snellere inference, maar kleinere modellen kunnen ook op CPUs en Apple Silicon Macs draaien. Stuur me je CPU, GPU/VRAM, RAM en gebruiksdoel, dan adviseer ik een realistische configuratie.
Heeft dit een actieve internetverbinding nodig om te werken?
Voor het kernsysteem is geen internetverbinding nodig nadat de benodigde modellen en dependencies zijn geïnstalleerd. Optionele externe integraties kunnen wel netwerktoegang vereisen.
Worden mijn prompts en documenten naar een externe AI API gestuurd?
De deployment kan zo worden ingesteld dat inference en document retrieval op je eigen machine of privé netwerk draaien, zonder prompts of documenten naar externe model APIs te sturen.
Welke documenten kan het RAG-systeem gebruiken?
Typische bronnen zijn PDF, DOCX, TXT, CSV en gestructureerde knowledge-base content. Vraag eerst of je gescande PDFs, ongewone formaten of een grote bestaande database hebt.
Ontvang ik de source code en setup-bestanden?
Ja, voor aangepaste code die voor jouw project is gemaakt. Derde-partij software en modellen blijven onder hun eigen licenties vallen. Ik voeg ook de afgesproken configuratie en overdrachtsdocumentatie toe.
Kun je het volledig air-gapped maken?
Ja, wanneer de geselecteerde software, modelbestanden en jouw omgeving een air-gapped deployment ondersteunen. Geef deze vereiste door voordat je bestelt, zodat de scope offline dependency handling omvat.
Kun je het installeren op Windows, Linux, macOS of een server?
Ja, afhankelijk van je hardware en de gekozen stack. Apple Silicon, NVIDIA GPU-systemen, CPU-only machines en VPS/server setups kunnen allemaal worden ondersteund met verschillende modelkeuzes.
Is model fine-tuning of training inbegrepen?
Nee, niet standaard. Deze dienst richt zich op deployment, RAG, integratie en lokale agent workflows. Fine-tuning is een aparte scope en moet worden besproken voordat je bestelt.
Hoe deploy ik het op mijn hardware?
Ik lever de projectbestanden en deployment-stappen en kan de setup begeleiden via Fiverr communicatie. De exacte methode hangt af van je omgeving en toegangssituatie.
Wat moet ik sturen voordat ik bestel?
Je besturingssysteem, CPU, GPU-model en VRAM, RAM, beschikbare opslag, doelgebruik, document/data types, voorkeursinterface en of je offline of air-gapped werking nodig hebt.