Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD

Bureau
Automatische vertaling
CUSTOM LLM FINE-TUNING | PRIVATE AI
Algemene AI-modellen kunnen domeinfeiten hallucinerend weergeven, jouw bedrijfscontext missen of privacyproblemen veroorzaken.
DE OPLOSSING
We stemmen open-source LLMs zoals Llama 3, Mistral & Qwen af op jouw eigen data, workflows en merksmaak voor gespecialiseerde prestaties, terwijl je data privé blijft.
WAAROM TKTURNERS
Full-stack AI-engineering met LoRA/QLoRA, expert dataset-curatie, NDA-naleving en veilige/air-gapped data handling.
WAT WE LEVEREN
<strong KWALITEITSGARANTIE
We herhalen het proces totdat het model voldoet aan de afgesproken benchmark metrics.
GRATIS AUDIT
Stuur een bericht voorafgaand aan je bestelling voor een gratis dataset audit & AI-architectuur roadmap.

Bureau
20 werknemers
Talen
Automatische vertaling

MEETOVO

S&D Moving

Empowering Confident Youth
Education Services
Automatische vertaling
Waarom moet ik je een bericht sturen voordat ik een bestelling plaats?
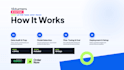
Fijn afstemmen hangt sterk af van de grootte, het formaat en het doel van jouw dataset. Eerst contact opnemen zorgt ervoor dat we de haalbaarheid van je data verifiëren en de meest kosteneffectieve open source architectuur kiezen.
Hoe zorg ik dat mijn eigen bedrijfsgegevens vertrouwelijk blijven?
Jouw data is strikt van jou. We voeren enterprise NDA's uit, gebruiken private air-gapped compute-omgevingen en verwijderen alle trainingsdata direct na afronding van het project.
Met welke open-source modellen kan ik fijn afstemmen?
We werken met top open-source modellen zoals Llama 3/3.1, Mistral/Mixtral, Qwen 2.5, Phi-3, Gemma 2 en gespecialiseerde code/embedding modellen.
Wie betaalt de GPU compute- en cloud-trainingskosten?
Computekosten (bijvoorbeeld RunPod, Lambda Labs, AWS EC2 of Colab Pro) worden rechtstreeks door de klant betaald. We optimaliseren het trainen met QLoRA om de kosten meestal onder de $10–$50 te houden.
Welk dataformaat moet ik aanleveren?
We accepteren JSONL, CSV, ruwe tekst, Markdown, PDFs of instructie-antwoordsparen. Als je data ongestructureerd is, kunnen we deze schoonmaken en formatteren tot hoogwaardige instructiedatasets.
In welk formaat wordt mijn fijn afgestemde model geleverd?
We leveren PEFT/LoRA adaptergewichten, samengevoegde safetensors, gequantiseerde GGUF-bestanden voor Ollama/LM Studio of een containerized vLLM/FastAPI-service.
Welke toegang heb je van mij nodig om te beginnen?
We hebben je sample/full dataset nodig en toegang tot je favoriete cloud GPU-instance (RunPod, Hugging Face of AWS) of lokale omgeving.
Wat wordt er gedekt onder revisies?
Revisies omvatten hyperparameter-aanpassingen (leersnelheid, epochs, rang), herbeoordeling op aangepaste validatiesets en conversie van exportformaten.
Kun je het fijn afgestemde model integreren in mijn bestaande webapp of API?
Ja. Als full-stack engineering bureau bouwen we FastAPI microservices, Docker containers en Next.js/Node.js frontends om je model soepel te laten werken.
Biedt u ondersteuning en onderhoud na oplevering?
Ja. De Premium tier bevat 14 dagen ondersteuning. We bieden ook doorlopende onderhoudspakketten voor retraining, dataset-updates en server-scaling.