Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD
PDF naar Tekst Document Conversie Doorzoekbare Offline Bibliotheken
Je contracten en technische documenten liggen op je eigen computer. Een clausule vinden
betekent bestanden één voor één openen en elke cloudtool die dit oplost, stuurt je
bestanden naar de servers van iemand anders.
Ik bouw het tegenovergestelde: een doorzoekbare bibliotheek die volledig op jouw computer draait.
WAT JE KRIJGT
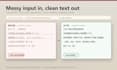
Geen installatie. Geen Python. Geen GPU. Geen commandoregel. Eén .html-bestand dubbelklikken en zoeken. Geen account, geen internet.
Elk resultaat toont het bronbestand en de pagina waar het vandaan komt.
Running headers, paginanummers en dubbele regels worden verwijderd.
WAT HET NIET DOET
- Zoekopdracht op trefwoorden, niet semantisch: exacte codes werken goed, "vind de clausule over late
betaling" werkt minder goed.
- Gescande pagina's hebben OCR nodig. Schone scans zijn prima, handschrift vaak niet.
- OCR-tekst kan fouten bevatten. Goed voor zoeken, niet voor citeren als autoriteit.
EXTRA'S
- Data bron connectiviteit: ik verbind extra bronnen (database, cloud drive,
website) in dezelfde bibliotheek.
- API-integratie: voegt een vraag-en-antwoord interface toe die je eigen API-sleutel gebruikt.
Je documenten verlaten je machine nooit.
- Broncode inbegrepen: de Python-pipeline die de bibliotheek bouwt, zodat je
hem later zelf kunt rebuilden.


Technologie:
Excel
•
Python
•
Overige
Automatische vertaling
Moet ik het hosten of betalen voor een abonnement?
Nee. Het is een enkel .html-bestand dat offline opent. Niets wordt geüpload naar een server.
Kun je Chinees aan?
Ja. Ik heb een doorzoekbare bibliotheek opgebouwd met meer dan 5.000 Chinese artikelen (9,6 miljoen characters) uit gescande PDFs en webpagina's. Chinese, Engelse en Japanse documenten zijn allemaal prima. (Ik ben Chinees, dus dit gaat gemakkelijk.)
Welke bestandstypen accepteert u?
Tekstgebaseerde PDFs, gescande PDFs (OCR), Word- en andere Office-bestanden, platte tekst en webpagina's. Stuur me een voorbeeld en ik bevestig het voordat je bestelt.
Is het echt offline? Waar gaan mijn documenten naartoe?
Nergens. Alles wordt op jouw computer gebouwd en geleverd als een enkel .html-bestand. Geen account, geen upload en geen internet nodig om te zoeken — je kunt de netwerkkabel loskoppelen en het blijft werken.
Kan het vragen beantwoorden in gewone taal, zoals een chatbot?
Niet in de standaard pakketten — die bieden zoekopdrachten op trefwoorden. Wil je een vraag-en-antwoord interface, voeg dan de "API integratie" extra toe: het gebruikt je eigen API-sleutel en houdt je documenten op je eigen machine.
Hoe zit het met gescande documenten en handschrift?
Gescande pagina's worden verwerkt met OCR. Schone, hoge-resolutie scans werken goed. Handschrift doet het vaak niet, en OCR-tekst kan fouten bevatten — geschikt voor zoeken, niet voor citeren.
Kan ik later meer documenten toevoegen?
Ja. Met de "Include source code" extra krijg je de Python pipeline en kun je de bibliotheek zelf opnieuw bouwen wanneer je bestanden toevoegt. Zonder deze, stuur me een bericht en ik geef een offerte voor een kleinere vervolgopdracht.
Wat als mijn set groter is dan 3000 pagina's, of PDFs en webpagina's combineert?
Stuur me een bericht voordat je bestelt. Ik bekijk je bestanden en stuur je een aangepaste offerte.