Door categorieën bladeren
Nederlands
$
USD
Koppel je AI aan Fiverr
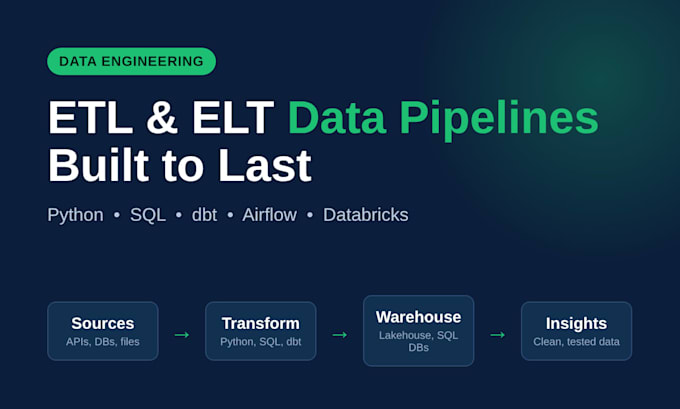
Data-ingenieur voor ETL- en ELT-pijplijnen, SQL, Python, dbt, Databricks
Noden aan betrouwbare datapijplijnen die ruwe data omzetten in schone, analyseklare tabellen? Ik ben een Data Engineer (Top Rated op Upwork, 100% Job Success, 1.000+ uren) en bouw ETL/ELT-pijplijnen die getest, gedocumenteerd en onderhoudbaar zijn.
WAT JE KRIJGT
MIJN PROCESS
Niet zeker welk pakket past? Stuur me een bericht voordat je bestelt en ik raad de juiste scope aan.
Automatische vertaling
Met welke tools en platforms werk je?
Python, SQL, dbt, Apache Airflow, PySpark en Databricks, met Postgres en andere relationele databases. Ik integreer ook API’s, platte bestanden en cloudopslag. Vertel me jouw stack en ik werk ermee.
Wat krijg ik bij oplevering?
Goed gestructureerde broncode, een korte README met setup- en run-stappen, en een walkthrough van hoe de pijplijn werkt. Standard en Premium bevatten ook een initiële data-audit en ontwerpadviezen.
