Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD
Rommelige webpagina's, feeds of Instagram-accounts worden omgezet in een overzichtelijke, gededupliceerde tabel die je kunt opvragen, op een schema wordt ververst, met een dashboard of API er bovenop.
Het verschil met een gewone scraper: een AI-stap leest elk item en vult de velden in die regexen niet kunnen, zoals categorie, prijsklasse, sentiment, entiteiten of de datum van het evenement die verstopt zit in een bijschrift. De output wordt gevalideerd volgens het schema voordat het de database bereikt, zodat foutieve antwoorden luidruchtig falen in plaats van je data te vervuilen.
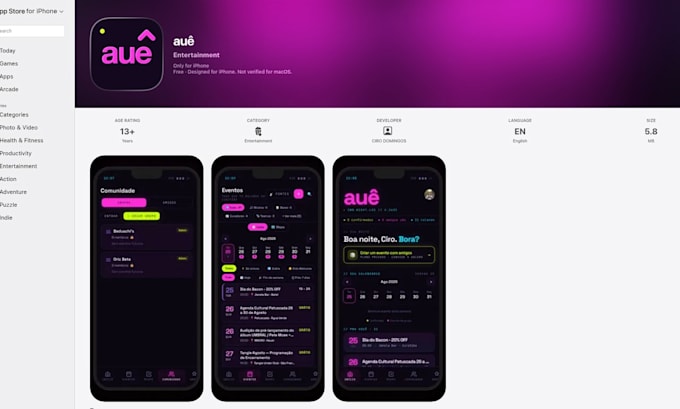
Bewijs: mijn events app haalt ongeveer 80 Instagram-accounts binnen via Apify en gebruikt Claude om dagelijks evenementvelden uit posts en afbeeldingen te halen. Mijn merk scraper doet hetzelfde voor merkkenmerken. Beide links staan op mijn profiel.
Wat je krijgt: de pipeline die wordt gedeployed op Railway of je eigen host, de tabel in SQLite of Postgres, een Streamlit dashboard of een FastAPI endpoint, en de kosten van elke run worden geregistreerd.
Hoe we beginnen: stuur twee voorbeeldpagina's en de kolommen die je wilt. Je krijgt een voorbeeldtabel van 100 rijen voordat de volledige run start.
Niet inbegrepen: sites die scraping verbieden in hun voorwaarden, inloggegevens, captchas.
Technologie:
Python
•
Google Sheets
•
Selenium
•
Toneelschrijver
•
Pandas
Techniek:
Geautomatiseerd
Automatische vertaling
Kan het op mijn server draaien?
Ja, of op Railway onder jouw account.
Wat kost het om te draaien?
Meestal onder de 20 dollar per maand; elke run registreert zijn kosten.