Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD


Automatische vertaling
Besteed jij uren aan handmatig hertypen van facturen, zorgclaims, bankafschriften of rommelige gescande formulieren in jouw software?
Ik bouw een enterprise-klasse Multimodal Document AI en OCR-gegevensextractiepijplijn die complexe, ongestructureerde documenten omzet in feilloze gestructureerde JSON met een nauwkeurigheid van 99,8%.
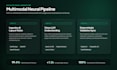
Door diepe-leermodel OCR-engines (DocTR, LayoutLM) te combineren met state-of-the-art Vision LLMs (GPT-4o, Claude 3.5 Sonnet), parses mijn pijplijnen moeiteloos dichtbezette multi-page tabellen, handgeschreven aantekeningen en scheve scans.
Wat ik lever:
- Aangepaste OCR-pijplijn gebouwd met DocTR, LayoutLM of OpenCV
- Multimodale Vision LLM-extractie met schema-constraint
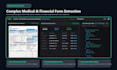
- Complexe formulier parsing (CMS-1500, UB-04, ACORD, facturen & bonnetjes)
- Pydantic-schemavalidatie ter voorkoming van onvolledige of beschadigde velden
- FastAPI asynchrone REST-microservice met Webhook-callbacks
- Docker-containertijdklare implementatie voor AWS, GCP, Azure of privé VPS
Technische stack:
Python, DocTR, PyTorch, OpenCV, GPT-4o, Claude 3.5 Sonnet, Pydantic, FastAPI, Docker.
Neem contact op voordat je bestelt met een voorbeelddocument, zodat ik de nauwkeurigheid kan benchmarken voor jouw specifieke use case!
Data Scientist and AI Engineer
Talen
Automatische vertaling
Automatische vertaling
Kun je gescande of lage-resolutie documenten verwerken?
Ja. Ik integreer OpenCV-preprocessing (deskewing, binarization, contrastaanpassing) en DocTR-Deep-Learning-modellen die specifiek zijn ontworpen om lage resolutie, gedraaide en ruisachtige scans te verwerken.
Welke formaten en types kun je extraheren?
Ik handel af met PDF (native en gescand), PNG, JPEG, TIFF, multi-page facturen, medische formulieren (CMS-1500, UB-04), belastingaangiften, ACORD-verzekeringscertificaten en geneste financiële tabellarische staten.
Hoe wordt de nauwkeurigheid van de data gegarandeerd?
Elke geëxtraheerde document doorloopt strikte Pydantic-VALIDA-lagen met veld-scores, typecasting en randvoorwaarden om schone, ingestion-ready JSON te garanderen.
Bied je een API-endpoint of Docker-implementatie aan?
Ja. De standaard- en premium-tiers bevatten een productie-FastAPI-microservice met asynchrone taakwachtrij, batchverwerking en volledige Docker-configuratie.