Door categorieën bladeren
Nederlands
$
USD
Maak verbinding met je AI
Full Stack, Backend en Data Engineer
Zet digitale PDFs en gescande formulieren om naar gestructureerde data die jouw team kan gebruiken.
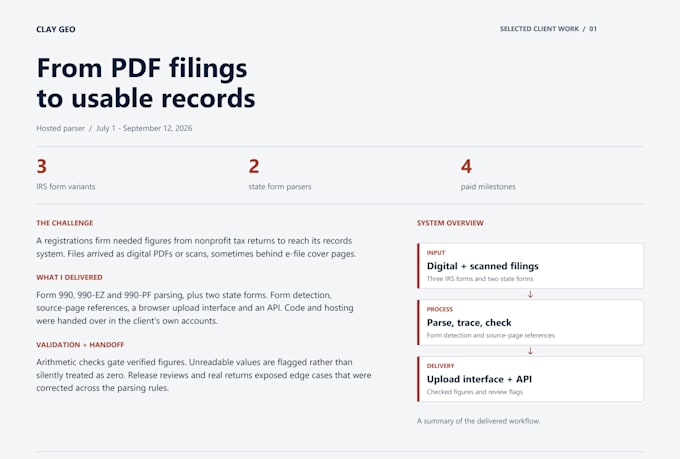
Ik bouw herbruikbare Python-extractieworkflows voor afgesproken documentenlay-outs, met CSV- of JSON-uitvoer en controles op ontbrekende of ongeldige velden. Een afgerond klantproject bevatte een aangepaste PDF-dataparser.
Basic dekt één digitale PDF-layout. Standard voegt OCR toe voor beoordeelde gescande documenten. Premium voegt meer layouts en één extraction API-endpoint voor jouw applicatie toe. Elk pakket bevat broncode, voorbeeldoutput, referenties naar pagina's, validatie-flaggen en setup/handoff-notities.
Ik bekijk eerst representatieve voorbeelden, spreek de velden en de verwachte resultaten af, en test vervolgens de parser tegen die voorbeeldset. OCR-resultaten hangen af van de kwaliteit van het document; de workflow markeert gedetecteerde uitzonderingen voor beoordeling.
Pakketten dekken de genoemde layouts, totale velden en initiële testpagina's. Verstuur voorbeelddocumenten en jouw gewenste output vóór het bestellen. Grotere archieven, complexe tabellen, sterk variërende layouts of extra integraties kunnen apart gequote worden. Hosting- en verwerking door derden zijn apart.


Technologie:
Python
Automatische vertaling
Wat telt als een layout of een veld?
Een layout is één consistente documentsjabloon. Een veld is één uitvoerkolom of JSON-sleutel; veldlimieten gelden over het afgesproken schema. Complexe tabellen of grote variaties in sjablonen vereisen aparte beoordeling.
Kun je gescande PDFs en handschrift verwerken?
Standard en Premium bevatten OCR voor beoordeelde scans. Handschrift, verslechterde pagina's en sterk variërende layouts vereisen mogelijk een aangepaste scope na voorbeeldbeoordeling.
Hoe controleer je de extractiekwaliteit?
Ik vergelijk de uitvoer met afgesproken voorbeeldwaarden en rapporteer de resultaten. Ontbrekende of ongeldige waarden krijgen validatie-flaggen. OCR kan fouten maken, dus ik beloof geen perfecte nauwkeurigheid.
Wat is inbegrepen bij levering en revisies?
Broncode, voorbeeldoutput, referenties naar bronn pagina's, validatie-flaggen en setup-notities. Premium voegt één API-endpoint toe. Revisies verfijnen de afgesproken extractie; nieuwe layouts, velden of integraties vallen onder een aanvullende scope.