Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD
Ik bouw automatiseringen die tijd besparen en handmatig werk verminderen
Niveau 1
Voldoet aan bepaalde prestatiecriteria en toont een sterke potentie op de marktplaats.
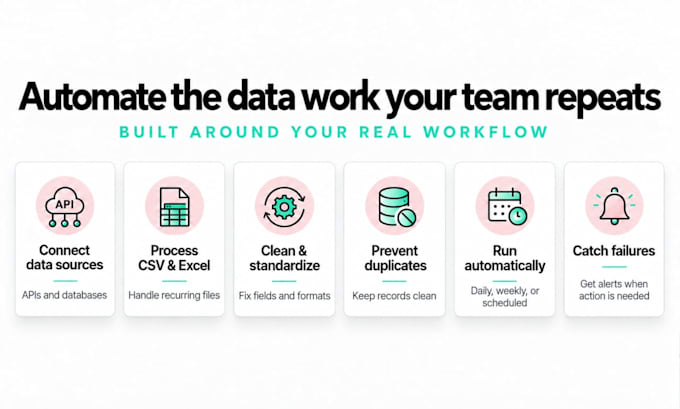
Ik bouw een geautomatiseerde data pipeline die je bedrijfsdata verzamelt, opschoont, transformeert en naar de juiste plek stuurt.
Ik kan werken met APIs, CSV, Excel, JSON, PostgreSQL, MySQL, Supabase, cloud storage en andere compatibele systemen.
Afhankelijk van het pakket kan je pipeline onder andere bevatten:
Data extractie en API-verbindingen
Schoonmaken, mapping, filteren en deduplicatie
Validatie en data-kwaliteitscontroles
Geplande automatische runs
Foutlogboeken en foutmeldingen
Tests, documentatie en deployment
Deze service is ideaal voor terugkerende data taken, rapportage workflows, database-updates en systeem-naar-systeem dataoverdracht.
Stuur me gerust een bericht voordat je bestelt met je data bron, bestemming, voorbeeldgegevens en het proces dat je wilt automatiseren, zodat ik het juiste pakket kan bevestigen.


Tools & platforms:
Overige
Automatische vertaling
Wat is een data pipeline of ETL pipeline?
Het is een geautomatiseerd proces dat data verzamelt van één bron, deze schoonmaakt of transformeert en naar een ander systeem stuurt. Bijvoorbeeld: API → data schoonmaken en valideren → PostgreSQL.
Met welke gegevensbronnen kunt u werken?
Veel voorkomende bronnen zijn REST APIs, CSV, Excel, JSON, PostgreSQL, MySQL, Supabase, cloud storage en andere systemen met toegankelijke APIs of databaseverbindingen.
Kan de pipeline automatisch draaien?
Ja. Standaard en Premium pakketten kunnen geplande runs bevatten zoals hourly, daily of weekly verwerking.
Kun je mijn data schoonmaken, combineren of transformeren?
Ja. Dit kan onder andere het hernoemen van velden, formatteren van data, filteren van records, verwijderen van duplicates, datasets samenvoegen, waarden converteren en bedrijfsregels toepassen omvatten.
Kun je een API verbinden met mijn database?
Meestal wel. Stuur me vooraf de API- en bestemminggegevens zodat ik toegang en haalbaarheid kan bevestigen.
Wat gebeurt er als de pipeline faalt?
Afhankelijk van het pakket kan ik logging, validatie, foutmeldingen, retry-logica en andere foutafhandelingsmaatregelen toevoegen.
Ontvang ik de broncode en documentatie?
Ja. De afgesproken source code en setup documentatie zijn inbegrepen, zodat je niet vastzit aan de levering.
Welke projecten vallen niet onder deze pakketten?
Grote enterprise data warehouses, Spark of Databricks architectuur, Kafka-scale streaming, grote migraties en andere complexe data-engineering systemen vereisen aparte scope en een maatwerk offerte.
Moet ik contact met u opnemen voordat ik bestel?
Ja. Stuur me eerst een bericht met je data bron, bestemming, voorbeeldgegevens en gewenste workflow zodat ik het juiste pakket en scope kan bevestigen.