Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD

Automatische vertaling
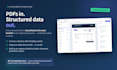
Elk uur dat jouw team besteedt aan het kopiëren van data uit PDFs naar Excel is een uur verspild en elke handmatige fout kost meer.
Ik ben een backend- en AI-systemen engineer. Ik heb een productie-gegevensextractiesysteem gebouwd dat meer dan 20.000 echte documenten heeft verwerkt, en ik zal hetzelfde soort systeem voor jouw bedrijf maken.
Wat je krijgt:
Gestructureerde data uit facturen, contracten, vrachtbrieven, rapporten en elk ander documenttype
Output precies zoals jij het nodig hebt: Excel, CSV, JSON of directe database/API-integratie
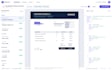
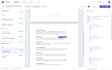
Bronmarkering: elke geëxtraheerde waarde wordt teruggeleid naar de exacte locatie in de originele PDF, zodat verificatie seconden in plaats van uren duurt
Confidence scores per veld, zodat jouw team alleen de dingen reviewt die echt aandacht nodig hebben
Waarom ik:
Werkervaring in productie, niet alleen scripts (meer dan 20.000 documenten verwerkt)
Python en Java backend engineer, ik kan integreren met jouw bestaande systemen
Duidelijke communicatie en eerlijke levertijden
Stuur me een voorbeelddocument (of een geredigeerde versie) en ik vertel je precies wat haalbaar is en wat het kost voordat je bestelt.
AI Automation Engineer, Document Data Extraction and Custom AI Systems
Talen
Automatische vertaling
Automatische vertaling
Welke documenttypes kun je verwerken?
Elk tekstgebaseerd PDF of scan: facturen, inkooporders, vrachtbrieven, contracten, verzekeringsformulieren, financiële rapporten. Stuur eerst een voorbeeld en ik bevestig de haalbaarheid.
Wat betekent "bronmarkering"?
Voor elk geëxtraheerd veld (bijvoorbeeld factuurbedrag) geeft het systeem ook de exacte positie in de originele PDF terug, zodat je resultaten direct kunt verifiëren tegen de bron.
Behandel je gescande documenten?
Ja — gescande documenten via OCR. Handgeschreven tekst: per geval, stuur eerst een voorbeeld.
Kan dit op mijn eigen infrastructuur draaien?
Ja. Premium omvat deployment support (Docker, cloud of on-premise), zodat jouw data nooit je omgeving verlaat.
Hoe zit het met dataprivacy?
Ik onderteken NDA's en kan de pipeline bouwen om documenten binnen jouw eigen infrastructuur te verwerken.


