Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD
Japanse LQA linguïstisch specialist data cleaning workflow automatisering
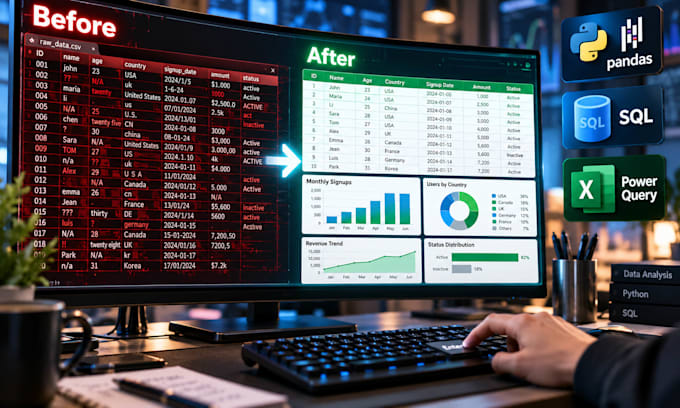
Heb je grote, complexe of rommelige datasets die Excel niet gemakkelijk aankan? Ik bied high-performance data cleaning, transformatie en analyse met Python (Pandas), SQL en Power Query.
Wat ik voor jou kan doen:
Tools die ik gebruik:
Waarom voor mij kiezen?
Stuur me gerust een bericht met een voorbeeld of beschrijving van je data voordat je een bestelling plaatst, zodat ik de beste aanpak voor jouw project kan adviseren!


Automatische vertaling
Ontvang ik het Python script of SQL code?
Ja! Op verzoek lever ik zowel de schoongemaakte dataset (CSV/Excel) als het herbruikbare Python script of SQL query bestand (.py / .sql).
Met welke gegevensformaten werkt u?
Ik accepteer CSV, XLSX, JSON, TXT en SQL database dumps. Als je data in een ander formaat is, neem dan eerst contact met me op.
Hoe ga je om met Japanse of meertalige datasets?
Als native Japanse en vloeiend Engels spreker, verwerk ik karaktercodering (UTF-8, Shift-JIS) en meertalige tekst naadloos.
Kun je datasets verwerken die groter zijn dan 100.000 rijen?
Ja, absoluut. Voor zeer grote datasets of complexe database pipelines, stuur me een bericht met details voor een op maat gemaakte offerte.