Door categorieën bladeren
Nederlands
$
USD
Koppel je AI aan Fiverr
Expert AI en Machine Learning Engineer
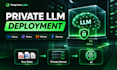
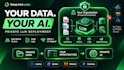
Ik implementeer open-source LLMs privé, binnen jouw eigen cloud-account of op jouw eigen servers. Niets gaat naar derde partij AI-API's.
Ik draai deze stack zelf: een 32B Qwen-model bediend met vLLM, achter een OpenAI-compatibele API, met API-sleutels, monitoringdashboards (Prometheus en Grafana) en alles verpakt in één Docker-image.
Wat je krijgt:
Optioneel: een RAG-chatbot die antwoordt uit jouw documenten en de bronnen laat zien.
Goed voor bedrijven die met private of gereguleerde data werken (klinieken, juridisch, interne documenten).
Stuur me eerst een bericht met jouw GPU of cloud en het model dat je voor ogen hebt, dan bevestig ik de juiste setup.
Frameworks:
Scikit-learn
•
DeepPy
•
Google ML Kit
•
PyTorch
Datatype:
Code
Programmeertaal:
Python
•
R
•
SQL
•
Amazon SageMaker
Tools:
Jupyter-notitieboek
•
tensorflow
•
Amazon SageMaker
•
Colab
Automatische vertaling
Heb ik mijn eigen GPU of cloud account nodig?
Beide opties werken. Ik kan deployen op jouw eigen server of op een cloud-account die jij bezit (AWS, RunPod en vergelijkbaar). Stuur me eerst een bericht en ik adviseer de GPU-grootte voor jouw model.
Gaat mijn data van mijn servers af?
Nee. Het model draait in jouw omgeving en er wordt niets naar derde partij AI-API's gestuurd. Ik heb alleen toegang nodig voor de setup, en je kunt die daarna verwijderen.
Welke modellen kan je inzetten?
Open-source modellen zoals Qwen, Llama en Gemma, met quantization. De beste keuze hangt af van je GPU-geheugen en jouw gebruikssituatie.
Kan de assistant antwoorden uit mijn eigen documenten?
Ja, dat is de optionele RAG-add-on. Het antwoordt uit jouw bestanden en toont de bron. Geef vóór het bestellen het documenttype en het volume door.
Wat heb je van mij nodig om te beginnen?
Jouw GPU- of cloudgegevens, het model dat je voor ogen hebt (indien aanwezig), en welke apps het zullen aanroepen. Ik bevestig de setup voordat we beginnen.


