Door categorieën bladeren
Nederlands
$
USD
Maak verbinding met je AI

Automatische vertaling
Jouw LLM-functie is door de demo gekomen. Zal hij ook slagen na de volgende prompt of bij een modelwijziging?
Ik bouw evaluatiesets die dat beantwoorden. Je krijgt een rubric geschreven voor jouw use case, een testset met verwachte antwoorden en, als een LLM jouw outputs beoordeelt, een controle hoe betrouwbaar die judge is.
Wat je krijgt:
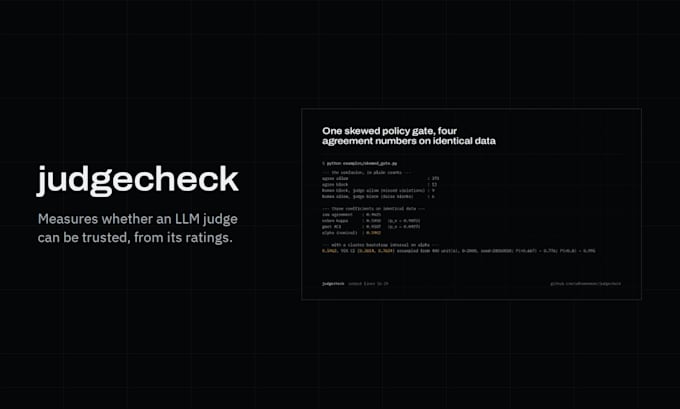
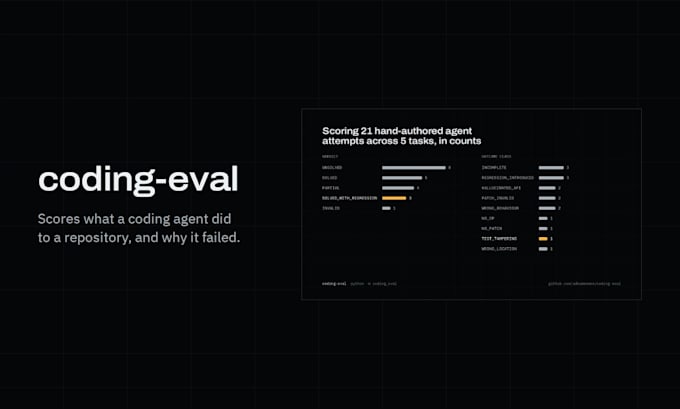
Waarom ik: ik bouwde judgecheck, een betrouwbaarheidrapport voor LLM-judges die laat zien hoe 96% ruwe overeenstemming kans-gecorrigeerde scores zo laag als 0,60 kan verbergen, en coding-eval, waarmee coding-agentpogingen in een sandbox worden herhaald (20 van 21 beweerde successen; 5 geslaagd). Ik evalueer frontier-model code professioneel en bouw rubric- en kalibratietools voor Arabic klinische AI.
Stuur me een bericht met wat de feature doet, een paar voorbeeldin- en outputs, en wat een goed antwoord voor jou is.
AI Red Teaming and LLM Evaluation Engineer
Talen
Automatische vertaling
Automatische vertaling
Wat heb je van me nodig?
Toegang tot het model of de API die je gebruikt (of een bestand met opgeslagen outputs), een paar echte voorbeeldinputs en eventuele menselijke beoordelingen die je al hebt. Als je er geen hebt, stemmen we samen een kleine beoordelingsronde af.