Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD
AI Full Stack Engineer SaaS mobiele apps en web scraping
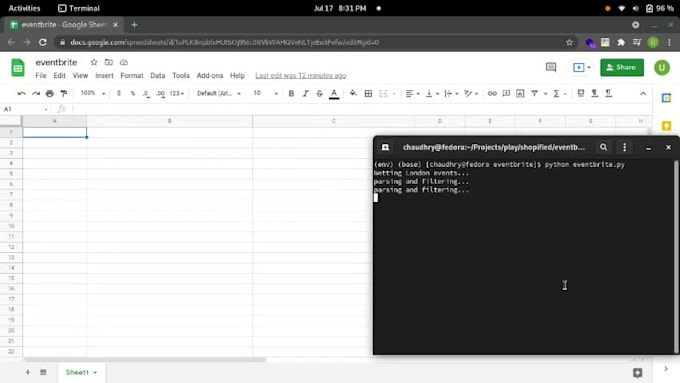
Wil je regelmatig data van websites zonder te kopiëren en plakken? Ik maak Python scrapers die het betrouwbaar verzamelen en schone, gestructureerde bestanden leveren of direct in jouw systemen invoeren.
Ik heb 15 jaar ervaring in software en bouw scrapers die doen wat goedkope scripts missen: JavaScript-rijke pagina's, oneindig scrollen, paginering, inloggegevens die jij bezit, en sites die hun layout aanpassen.
Wat je krijgt:
Veelgebruikte toepassingen: prijs tracking van concurrenten, leadlijsten uit openbare directories, vastgoed- en vacatureaanbiedingen, productcatalogi en review monitoring.
Ik scrapen alleen publiek beschikbare data en volg de voorwaarden van elke site.
Stuur me de website en de velden die je nodig hebt, en ik bevestig wat mogelijk is voordat je bestelt.



Technologie:
Python
•
NodeJS
•
Scrapy
•
Selenium
•
Toneelschrijver
Techniek:
Geautomatiseerd
Automatische vertaling
Welke soorten websites en data worden ondersteund?
Ik kan data extraheren uit openbare bedrijfsdirectory's, e-commerce winkels, prijs trackers en openbare vastgoedvermeldingen. De doelgerichte data moet volledig openbaar zijn en het project moet voldoen aan ethische scraping standaarden. Ik haal geen verborgen persoonlijke data of privégegevens op.
Kun je omgaan met complexe sites met dynamisch JavaScript of infinite scroll?
Ja. In tegenstelling tot eenvoudige no-code scraping tools, schrijf ik op maat gemaakte programmatische architectuur met Playwright, Selenium en Python. Hierdoor kan ik gemakkelijk diepe paginering, structurele layouts en dynamische client-side rendering navigeren.
Zijn de packages inclusief eigendom van de daadwerkelijke broncode?
De basis pakketten leveren de ruwe gecompileerde datasets (CSV, JSON, Excel). Als je volledige eigendom wilt van de schone workspace repository, op maat gemaakte automatiseringsscripts of cloud deployment pipelines, kunnen we code levering eenvoudig toevoegen als een op maat gemaakte upsell in chat.
Hoe houd je scraping ethisch en legaal?
Ik verzamel alleen publiek beschikbare data, respecteer de limieten zodat sites niet overbelast raken, en vertel je vooraf als de voorwaarden van een site geen scraping toestaan.