Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD
AI en Data Science ontwikkelaar, AI agents, Data analytics en AI automatisering
Niveau 1
Voldoet aan bepaalde prestatiecriteria en toont een sterke potentie op de marktplaats.
Verdrinkt in ruwe, ongestructureerde data zonder bruikbare antwoorden? Onverwerkte data verbergt belangrijke trends, inefficiënte operaties en verloren inkomstenkansen.
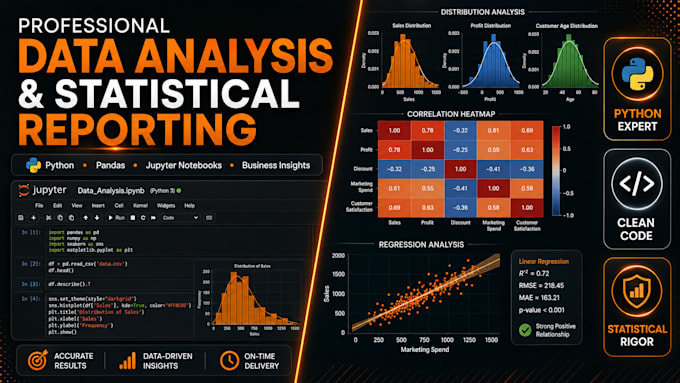
De oplossing: End-to-End Data Analyse, Data Cleaning en Statistische Rapportages die ruwe cijfers omzetten in duidelijke business intelligence.
Ik voer uitgebreide kwantitatieve data-analyse uit met Python, Jupyter Notebooks, Pandas en Excel.
Wat ik lever:
Technische stack:
Waarom voor mij kiezen?
Grondige statistische precisie & nul datafouten
Goed gedocumenteerde, volledig reproduceerbare code
Samenvattingen klaar voor besluitvorming
Klaar om echte inzichten uit jouw data te halen? Stuur vandaag nog een bericht om te beginnen!
Automatische vertaling
Welke tools gebruik je voor data-analyse?
Ik gebruik voornamelijk Python (Pandas, NumPy, Matplotlib) binnen Jupyter Notebooks, afhankelijk van de projectbehoeften, en Microsoft Excel.
Welke bestanden ontvang ik na voltooiing?
Je ontvangt de volledig commentaar gevende Jupyter Notebook (.ipynb), schoongemaakte dataset (CSV/Excel), geëxporteerde grafieken en een management-PDF rapport.
Kun je omgaan met rommelige of incomplete datasets?
Ja, data cleaning en preprocessing (omgaan met ontbrekende waarden, duplicaten en outliers) is een kernonderdeel van mijn service.
Wat is Exploratory Data Analysis (EDA)?
EDA is het proces van datasets analyseren om hun belangrijkste kenmerken samen te vatten, patronen te ontdekken, anomalieën te spotten en onderliggende hypotheses te testen.
Hoe deel ik mijn dataset veilig met jou?
Je kunt CSV-, Excel- of SQL-dumpbestanden direct uploaden via de Fiverr-opdrachtpagina of via beveiligde cloudlinks.
Kun je statistische hypothese testen uitvoeren?
Ja, ik voer rigoureuze inferentiële statistiek uit om correlaties, groepsverschillen en statistische significantie te testen.
Is de Python-code leesbaar en goed gecommentarieerd?
Ja, alle codeblokken zijn netjes gestructureerd met duidelijke Markdown-verklaringen zodat iedereen kan volgen.
Hoe groot kan een dataset zijn die je kunt analyseren?
Ik kan datasets verwerken variërend van kleine spreadsheets met honderden rijen tot miljoenen records met geoptimaliseerde Python-libraries.
In welke formaten kan ik grafieken exporteren?
Hoge-resolutie PNG, JPEG, SVG of vector PDF's, klaar voor presentaties of publicaties.
Kun je reproduceerbare analyse scripts opzetten voor toekomstige data?
Ja, ik schrijf herbruikbare functies zodat je hetzelfde script moeiteloos kunt herhalen op nieuwe datasets.
