Door categorieën bladeren
Nederlands
$
USD
Koppel je AI aan Fiverr
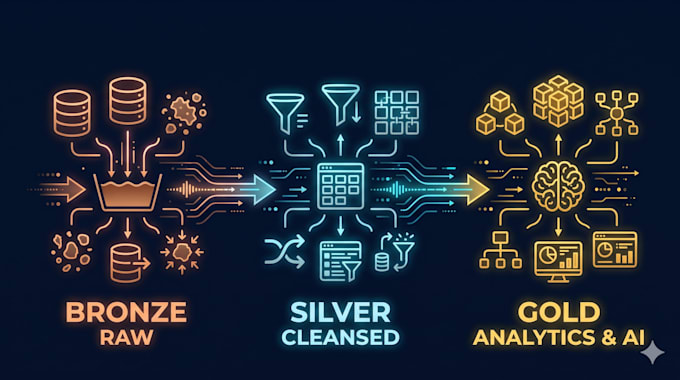
Heb je te maken met trage SQL-query’s, rommelige data-silos of hoge cloud-kosten? Ik ben een Enterprise Data Engineer (Microsoft Azure-gecertificeerd) die gespecialiseerd is in PySpark, Azure Databricks, Delta Lake en SQL. Ik ontwerp, optimiseer en bouw fouttolerante data-architecturen die ruwe data omzetten naar analytics-ready en AI-ready pipelines.
Wat ik voor jou kan doen:
Waarom met mij werken?
Stuur me een bericht voordat je bestelt zodat we jouw data-stack en scope kunnen afstemmen!
Automatische vertaling
Kun je ook de daadwerkelijke PySpark / SQL-code schrijven naast het architectuurontwerp?
Ja! Naast audit en architectuurblauwdrukken schrijf ik production-ready PySpark-scripts, Databricks-notebooks en geoptimaliseerde SQL-queries. Stuur me je wensen voor een op maat gemaakte implementie-offer.