Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD


Automatische vertaling
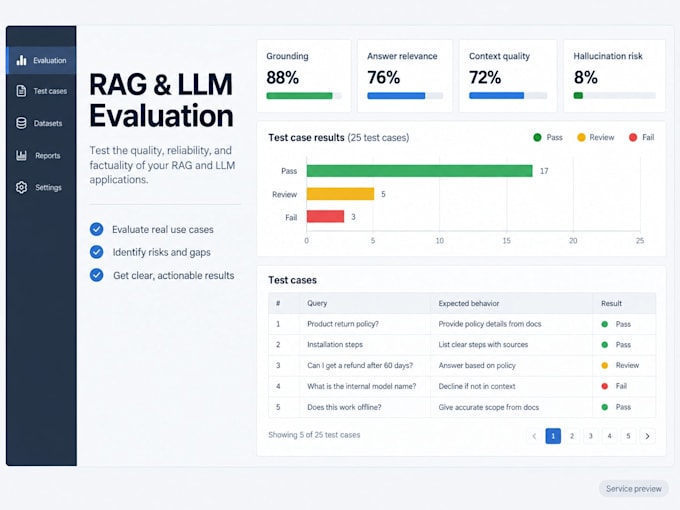
Geeft je RAG of LLM toepassing onterechte, irrelevante of inconsistente antwoorden? Ik evalueer het gedrag en geef op bewijs gebaseerde aanbevelingen voor verbetering.
Ik kan beoordelen:
Relevantie, duidelijkheid en volledigheid van antwoorden
Verankering in opgehaalde context
Hallucinaties en onterechte beweringen
Retrieval-kwaliteit en bruikbaarheid van bronnen
Citaties consistentie
Faalpatronen en fallback gedrag
Latentie- en kostenindicatoren wanneer data beschikbaar is
Beslissingen over chunking, context en modelconfiguratie
Afhankelijk van het pakket, review ik aangeleverde testcases, creëer ik een gestructureerde evaluatieset, analyseer ik retrieval- en generatiefouten en gebruik ik geautomatiseerde metrics wanneer dat technisch passend is. Je ontvangt een duidelijk rapport met observaties, bewijs, beperkingen en prioritaire aanbevelingen.
Voorzie een veilige testomgeving of geëxporteerde resultaten van de toepassing, opgehaalde contexten, verwachte antwoorden indien beschikbaar, en een beschrijving van de beoogde gebruikers en gebruikssituatie. Verwijder API-sleutels, productiegegevens en privéklantgegevens.
Deze dienst evalueert een bestaand systeem. Grote wijzigingen doorvoeren, de RAG-pipeline opnieuw opbouwen, productie-implementatie en
Python Backend Applied AI Developer
Talen
Automatische vertaling
Automatische vertaling
Q: Wat telt als één evaluatiegeval?
A: Eén geval omvat een gebruikersvraag, het gegenereerde antwoord en de opgehaalde context of bronnen die gebruikt zijn om het te produceren. Verwachte of referentieantwoorden zijn handig maar niet altijd vereist.
Q: Heb ik toegang nodig tot mijn productie systeem?
A: Nee. Ik geef de voorkeur aan een veilige testomgeving, geëxporteerde resultaten of een reproduceerbare lokale versie. Verwijder API-sleutels, productiegegevens, persoonlijke informatie en vertrouwelijke klantgegevens voordat je iets deelt.
Q: Welke evaluatiemetrics gebruik je?
A: Metrics hangen af van de toepassing en beschikbare data. Evaluatie kan betrekking hebben op antwoordrelevantie, contextrelevantie, trouw, bronverankering, retrieval-kwaliteit, hallucinatiepatronen, latentie en kostenindicatoren. Geautomatiseerde tools zoals RAGAS of vergelijkbare methoden kunnen worden gebruikt wanneer passend.
Q: Voer je de aanbevolen verbeteringen door?
A: Deze dienst richt zich op evaluatie en aanbevelingen. Kleine afgesproken aanpassingen kunnen apart worden aangeboden, terwijl grote pipeline-wijzigingen, nieuwe functies en deployment een aangepaste offerte vereisen.
Q: Kan je garanderen dat de evaluatie hallucinaties elimineert?
A: Geen enkele verantwoordelijke evaluator kan garanderen dat een LLM nooit zal hallucineren. Ik identificeer waargenomen faalpatronen, meet ze waar mogelijk en doe praktische aanbevelingen om hun frequentie en impact te verminderen.