Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD


Automatische vertaling
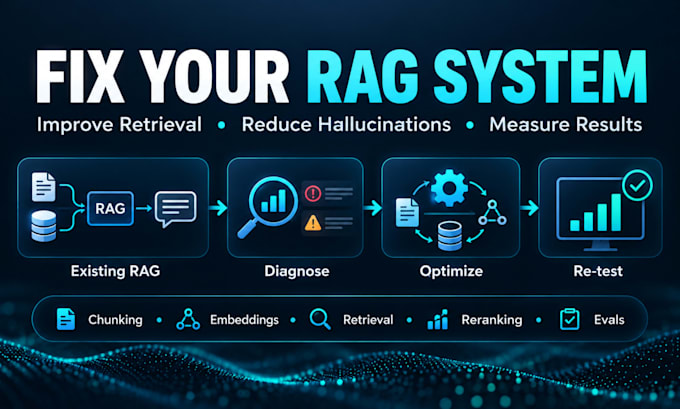
Geeft jouw RAG-systeem de verkeerde documenten terug, hallucineert het, produceert het onbetrouwbare citaties of reageert het te langzaam?
Ik diagnoseer en optimaliseer je bestaande RAG-pipeline met meetbare voor- en na-testen, niet met willekeurige promptwijzigingen.
Ik kan helpen verbeteren:
- Chunking strategie
- Embeddings en vector search
- Retrieval nauwkeurigheid
- Metadata filtering
- Hybride search
- Reranking
- Prompt- en contextopbouw
- Hallucinatie vermindering en grounding
- Citatiekwaliteit
- Latentie en tokengebruik
- Vector database prestaties
- RAG evaluatie
Mijn proces:
Meten -> Diagnose -> Fixen -> Her-testen -> Vergelijken
Ik werk met Python-gebaseerde RAG-systemen, LangChain, LlamaIndex, FastAPI, OpenAI, Claude, lokale LLMs, Pinecone, Qdrant, Chroma, Weaviate, pgvector en soortgelijke stacks.
Je ontvangt duidelijke bewijsvoering van:
- Wat het probleem veroorzaakte
- Wat er is veranderd
- Hoe het systeem presteerde voor en na
- Eventuele resterende beperkingen
Deze dienst is voor bestaande RAG-systemen. Voor grote productiesystemen, meerdere integraties of herbouw van architectuur, neem eerst contact met mij op voordat je bestelt.
AI and Data Science Engineer, RAG, MCP and LLM Automation
Talen
Automatische vertaling
Automatische vertaling
1. Bouw je een nieuw RAG-systeem vanaf nul?
Deze dienst richt zich op het diagnosticeren en verbeteren van een bestaande RAG-pipeline. Nieuwe systeemontwikkeling moet worden aangepakt als een maatwerkproject.
2. Kun je hallucinaties verminderen?
Ja. Ik onderzoek of hallucinaties komen door retrieval, chunking, contextopbouw, prompting, citaties of modelgedrag en los de werkelijke oorzaak op.
3. Kun je de retrieval-nauwkeurigheid verbeteren?
Ja. Ik kan chunking, embeddings, vector search, metadata filters, hybride search, reranking en retrieval-instellingen herzien.
4. Kun je werken met Pinecone, Qdrant, Chroma, Weaviate of pgvector?
Ja, afhankelijk van je huidige architectuur en projectvereisten.
5. Kun je latency en API-kosten optimaliseren?
Ja. Latency, tokengebruik, contextgrootte, onnodige LLM-aanroepen en retrieval-efficiëntie kunnen worden herzien en geoptimaliseerd.
6. Kun je een specifieke nauwkeurigheidsverbetering garanderen?
Nee. Ik meet eerst de huidige baseline en rapporteer vervolgens de daadwerkelijke verbetering die is bereikt op representatieve testcases.
7. Wat heb ik nodig om te starten?
Geef je broncode of repository, huidige RAG-architectuur, vector database, embedding model, voorbeeld documenten uit de knowledge-base, representatieve testvragen en een paar voorbeelden van de fouten die je wilt laten oplossen. Als je verwachte antwoorden, logs of evaluatieresultaten hebt, zijn die ook handig.