Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD


Automatische vertaling
Ben je klaar om de kracht van LLMs en aangepaste AI naar jouw bedrijf te brengen?
Ik ben een softwareontwikkelaar die gespecialiseerd is in Artificial Intelligence integraties, RAG (Retrieval-Augmented Generation) architecturen en moderne webapplicaties. Of je nu een eenvoudige backend API nodig hebt of een complete aangepaste chatapplicatie die veilig jouw documenten opvraagt, ik kan een robuuste oplossing op maat maken die aan jouw wensen voldoet.
Wat ik aanbied:
Aangepaste RAG-systemen: Chat met je PDFs, databases of bedrijfsdocumenten via lokale of cloud-gebaseerde LLMs.
Backend & APIs: Snelle, veilige en schaalbare endpoints gebouwd met Python en FastAPI, volledig geoptimaliseerd voor token streaming.
Full-Stack oplossingen: Naadloze en responsieve frontend interfaces ontwikkeld met React en TypeScript.
Lokale AI-implementatie: Opzetten van privacy-first lokale modellen met Ollama en vector databases zoals Qdrant.
Mijn tech stack:
Python, FastAPI, React, TypeScript, JavaScript, SQL, Ollama, Qdrant, Hugging Face.
Stuur me alsjeblieft een bericht voordat je een bestelling plaatst! Ik wil jouw specifieke wensen begrijpen om ervoor te zorgen dat we de beste architecturale aanpak voor jouw project kiezen.
AI Backend Engineer RAG Vector Search
Talen
Automatische vertaling
Automatische vertaling
Waarom zou ik kiezen voor een aangepaste AI-architectuur in plaats van generieke commerciële platforms?
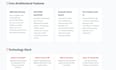
Een op maat gemaakte build geeft je volledige eigendom en controle. In plaats van je data in een star framework te dwingen, ontwerpen we een op maat gemaakte Retrieval-Augmented Generation (RAG) pipeline die precies aansluit bij jouw bedrijfslogica en vendor lock-in voorkomt.
Hoe leest en doorzoekt het systeem mijn specifieke bedrijfsdocumenten?
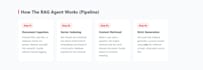
We integreren moderne vector databases, zoals Qdrant, om je PDFs, databases of bedrijfs tekst te verwerken. Hierdoor kan het systeem direct de meest relevante context vinden op basis van semantische betekenis en de juiste informatie aan de AI doorgeven.
Hoe voorkom je dat de AI feiten verzint (hallucineert)?
De architectuur gebruikt een strikte RAG-aanpak. Het model is beperkt tot antwoorden alleen met behulp van de context die uit je geverifieerde documenten wordt gehaald. We scheiden strikte logica van taalgeneratie om te zorgen dat je data 100% nauwkeurig blijft.
Kan dit omgaan met zeer gevoelige bedrijfsgegevens?
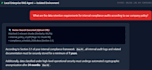
Absoluut. Voor maximale beveiliging kan ik privacy-first lokale AI-implementaties opzetten met Ollama. Dit betekent dat de Large Language Models (LLMs) en je data volledig op je eigen infrastructuur draaien, zodat nooit iets wordt verzonden naar derden.
Welke technologieën gebruik je voor de applicatie?
De backend wordt aangedreven door Python en FastAPI, wat snelle, schaalbare endpoints garandeert die geoptimaliseerd zijn voor AI token streaming. Als je een full-stack oplossing nodig hebt, is de frontend gebouwd met responsieve React en TypeScript.
Hoe starten we een nieuw project?
Stuur me alsjeblieft een direct bericht voordat je een bestelling plaatst. We bespreken jouw specifieke wensen, datatypes en gebruikssituatie om de meest effectieve architecturale aanpak voor jouw behoeften te kiezen.


