Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD


Automatische vertaling
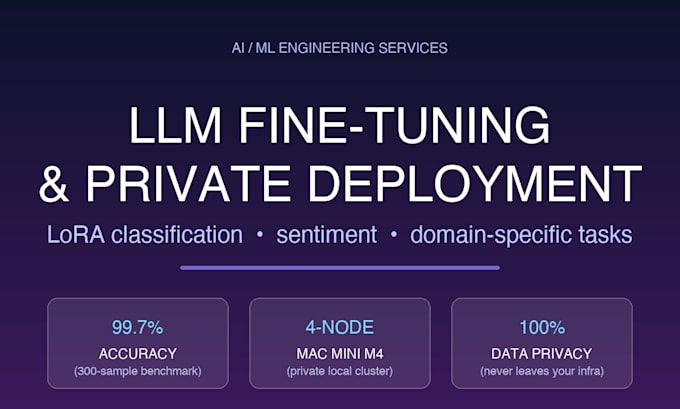
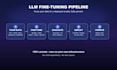
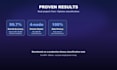
Op maat gemaakte LLM-fijn afstemming (LoRA/QLoRA) voor classificatie, sentiment, stijltransfer en domeinspecifieke taken. Ik heb een fact/oordeel binary classifier gebouwd met Qwen3-14B-4bit LoRA, met een nauwkeurigheid van 99,7%. Ik beheer een privé 4-knooppunt Mac Mini M4 cluster, waardoor ik je model volledig op je eigen infrastructuur kan fijn afstemmen en implementeren - je data blijft altijd onder jouw controle.
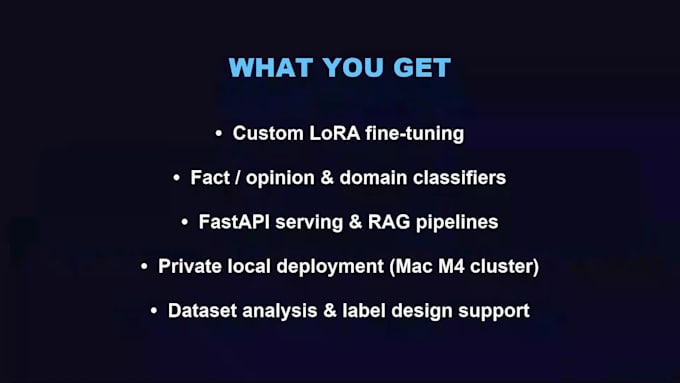
Wat ik aanbied:
- LoRA/QLoRA fijn afstemming op open-source modellen (Qwen, Llama, Mistral, etc.)
- Private deployment via FastAPI voor lokaal/on-premise gebruik
- RAG pipelines voor document Q&A over je private knowledge base
- Evaluatierapporten met nauwkeurigheid, F1 en foutanalyse
- Iteratief afstemmen totdat het model aan je target metrics voldoet
Waarom ik:
- 99,7% benchmarkresultaat op een echt classificatieproject
- Data blijft 100% in jouw omgeving - geen derde partij cloud, geen lekken
- Snelle, duidelijke communicatie in Engels & Chinees
Voor je bestelt: stuur me een bericht met je taakomschrijving, datasetgrootte en -formaat, doeltaal en deadline, zodat ik de haalbaarheid en levertijd kan bevestigen voordat je bestelt.
AI ML Engineer, LLM Fine tuning and Private Deployment Specialist
Talen
Automatische vertaling
Automatische vertaling
Welke gegevens heeft u van mij nodig?
Gelabelde of niet-gelabelde samples in CSV/JSON, of een taakomschrijving.
Blijft mijn data privé?
Ja, al het werk wordt uitgevoerd op mijn private lokale cluster, data verlaat nooit jouw infrastructuur.
Wat krijg ik na levering?
Fijn afgestemde modelgewichten, evaluatierapport en implementatiegids/API indien van toepassing.
Welke modellen stem je af?
Populaire open-source modellen zoals Qwen, Llama, Mistral en meer, met behulp van efficiënte LoRA/QLoRA.
Hoelang zal het duren?
Typische kleine tot middelgrote taken worden geleverd binnen 3-7 dagen, afhankelijk van datavolume en clusterbelasting.
Kun je niet-Engelse tekstdata verwerken?
Ja, ik kan meertalige modellen zoals Qwen, BLOOM of meertalige MiniLM fijn afstemmen voor niet-Engelse classificatie en NLP-taken. Deel je taal en domein en ik zet het juiste model voor je op.