Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD
AI Data Engineer, RAG Pipelines, PDF naar Markdown, Local LLMs
Bescherm je eigendomsgegevens van je bedrijf met een 100% privé, lokaal fijn afgestemde AI.
Het versturen van gevoelige zakelijke documenten, instructiemateriaal of interne kennis naar publieke cloud-API's vormt een groot beveiligingsrisico en schendt vaak GDPR-regelgeving.
Ik bouw veilige, offline AI-modellen die op maat gemaakt zijn voor jouw specifieke branche. Door gebruik te maken van high-end Apple Silicon-architectuur (128 GB Unified Memory) en geavanceerde frameworks zoals MLX en Unsloth, blijft je data tijdens het trainingproces altijd op mijn geïsoleerde, lokale hardware.
Wat ik lever:
Mijn Tech Stack & Expertise:
Neem contact met me op voordat je een bestelling plaatst


Programmeertaal:
Python
Datatype:
Tekst
AI engine:
Overige
Automatische vertaling
Waarom zou ik lokaal fine-tunen in plaats van OpenAI of andere cloud-API's te gebruiken?
Cloud-API's vormen een groot beveiligingsrisico voor eigendomsgegevens van je bedrijf en schenden vaak strikte GDPR-beleidsregels. Lokaal fine-tunen garandeert dat je gevoelige documenten, klantgegevens en interne kennis nooit het geïsoleerde, offline omgeving verlaten. Je behoudt 100% data-soevereiniteit.
Ben je in staat om grotere modellen te fine-tunen op lokale hardware?
Ja. Ik maak gebruik van een high-end Apple Silicon-architectuur met 128 GB Unified Memory. In combinatie met geavanceerde quantisatie-frameworks zoals MLX en Unsloth (QLoRA) zorgt deze enorme geheugenbandbreedte ervoor dat ik grote open-source modellen (zoals Llama, Mistral of Qwen) efficiënt kan fine-tunen en uitvoeren.
In welk formaat moeten mijn trainingsgegevens zijn?
Voor het Standaard pakket moet je data worden voorbereid als een schoon JSONL-bestand met gestructureerde instructie-antwoordparen. Als je kennis momenteel vastzit in rommelige PDFs, ruwe tekst of interne documenten, bevat mijn Premium pakket aangepaste Python preprocessing om te extraheren, schoon te maken en te formatteren.
Welke exacte bestanden ontvang ik bij levering?
Je ontvangt de fine-tuned LoRA-adaptergewichten samen met een volledig samengevoegd en gequantiseerd modelbestand (GGUF-formaat). Dit GGUF-bestand is deployment-klaar en kan direct worden gesleept en neergezet in lokale inference-engines zoals Ollama, LM Studio of AnythingLLM op je eigen bedrijfs-hardware.
Hoe zorg je ervoor dat het model echt mijn domein leert en niet alleen overfit?
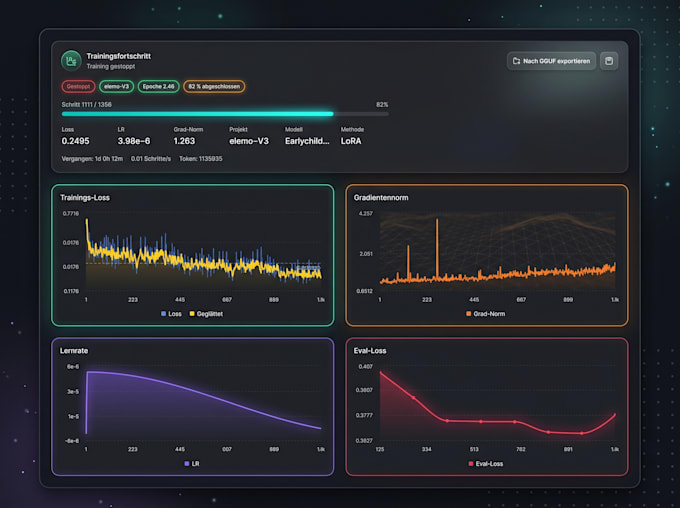
Ik monitor streng de verliescurves tijdens training en pas hyperparameters aan om te zorgen dat het model goed generaliseert naar jouw specifieke terminologie.