Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD
Moet je data verplaatsen, transformeren, opschonen of synchroniseren tussen databases, bestanden of APIs?
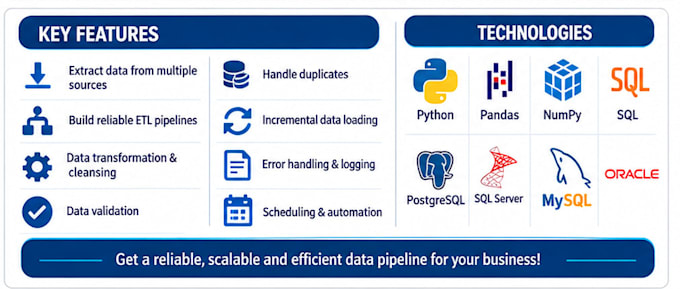
Ik bouw een betrouwbare ETL/ELT data pipeline met Python en SQL om data tussen verschillende bronnen en doel-databases te verplaatsen.
Ik kan eenvoudige batch pipelines maken, maar ook meer gestructureerde data-integratieoplossingen.
Ik kan pipelines bouwen voor:
TECHNOLOGIEËN
Automatische vertaling
V: Kun je data verplaatsen tussen PostgreSQL en SQL Server?
A: Ja. Ik kan batch-gebaseerde pipelines bouwen tussen PostgreSQL en SQL Server.
V: Kun je werken met APIs?
A: Ja. Ik kan data extraheren uit REST APIs en laden in databases.
V: Kunt u grote datasets verwerken?
A: Ja. Ik kan batching, incrementele loading en database-side verwerking gebruiken om geheugen- en database-overhead te verminderen.
Q: Kun je dubbele data opschonen?
A: Ja. Ik kan validatie- en duplicaatdetectieregels implementeren op basis van jouw bedrijfsvereisten.
V: Kun je de pipeline plannen?
A: Ja. Planning kan worden geïmplementeerd met beschikbare tools zoals cron of andere orkestratieplatformen, afhankelijk van jouw omgeving.