Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD
AI EN ML
Heb je een classificatieprobleem maar weet je niet zeker welk model het beste bij jouw data past?
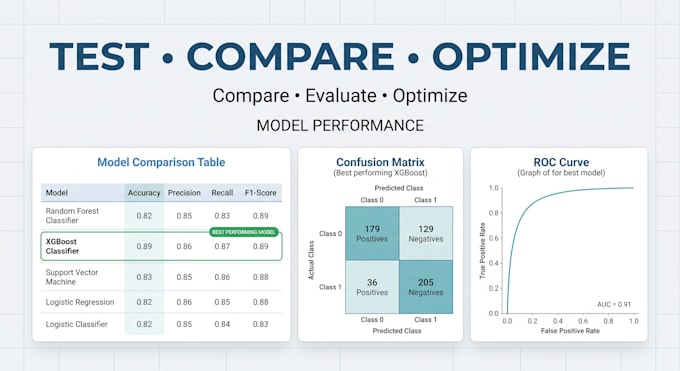
Ik bouw, train en vergelijk meerdere classificatiemodellen op jouw data
niet zomaar één populair algoritme, maar evalueer ze op onzichtbare data met behulp van
de metrics die bij jouw probleem passen (precisie, recall, F1, of andere).
Wat is inbegrepen:
Ik werk met numerieke, categorische en tekstuele data, binair, multiclass of multilabel classificatie.
Een recent voorbeeld: ik heb een phishing-e-mail classifier gebouwd op meer dan 108K e-mails
(projectnaam: FoxLens, live demo op Streamlit). In plaats van alleen de nauwkeurigheid te rapporteren, heb ik het grondig getest, een echte zwakte opgespoord (over-reliance op link aanwezigheid) teruggeleid naar de trainingsdata, en dit publiekelijk gedocumenteerd
dezelfde standaard die ik op elk project toepas: een werkend model, een zinvolle
evaluatie en een eerlijke beschrijving van waar het mogelijk moeite mee heeft.
Wil je deployment of API-integratie? Ik bespreek dat graag apart.


Expertise:
Classificatie
•
Voorspellende analyse
Programmeertaal:
Python
•
Overige
Frameworks:
Scikit-learn
•
Panda
•
Overige
Tools:
Jupyter-notitieboek
•
Excel
Automatische vertaling
Wat heb je van mij nodig om te beginnen?
Stuur je dataset (CSV, Excel of een ander ondersteund formaat), een korte beschrijving van het classificatieprobleem en de verwachte output. Als je al een target kolom hebt of specifieke wensen, vermeld die dan ook.
Kun je werken met zowel numerieke als tekstuele data?
Ja. Ik kan classificatieoplossingen bouwen voor numerieke, categorische en tekstuele data, afhankelijk van de structuur en eisen van jouw project.
Welke soorten classificatieproblemen behandel je?
Ik kan werken met binary, multiclass en multilabel classificatieproblemen. De juiste aanpak hangt af van jouw dataset en doelstelling.
Kun je een bestaand model verbeteren of optimaliseren?
Ja. Als je al een classificatiemodel hebt, kan ik het evalueren, mogelijke zwakke punten identificeren, de parameters afstemmen en vergelijken met andere geschikte benaderingen.
Ontvang ik de source code en het getrainde model?
Ja. Je ontvangt de Python broncode en het getrainde model of pipeline die voor jouw project is gemaakt, samen met de relevante resultaten en instructies om het te gebruiken.
Kun je het model deployen of integreren in een API?
Ja, deployment en API-integratie kunnen worden verzorgd voor projecten die dat vereisen. Geef je deployment wensen door zodat ik de juiste scope kan bepalen en indien nodig een maatwerk offerte kan maken.
Kun je werken met grote datasets of complexe projecten?
Ik kan werken met kleine tot middelgrote datasets binnen de scope van deze Gig. Grotere datasets, complexe pipelines of projecten die veel rekenkracht vereisen, kunnen een maatwerk offerte vereisen.